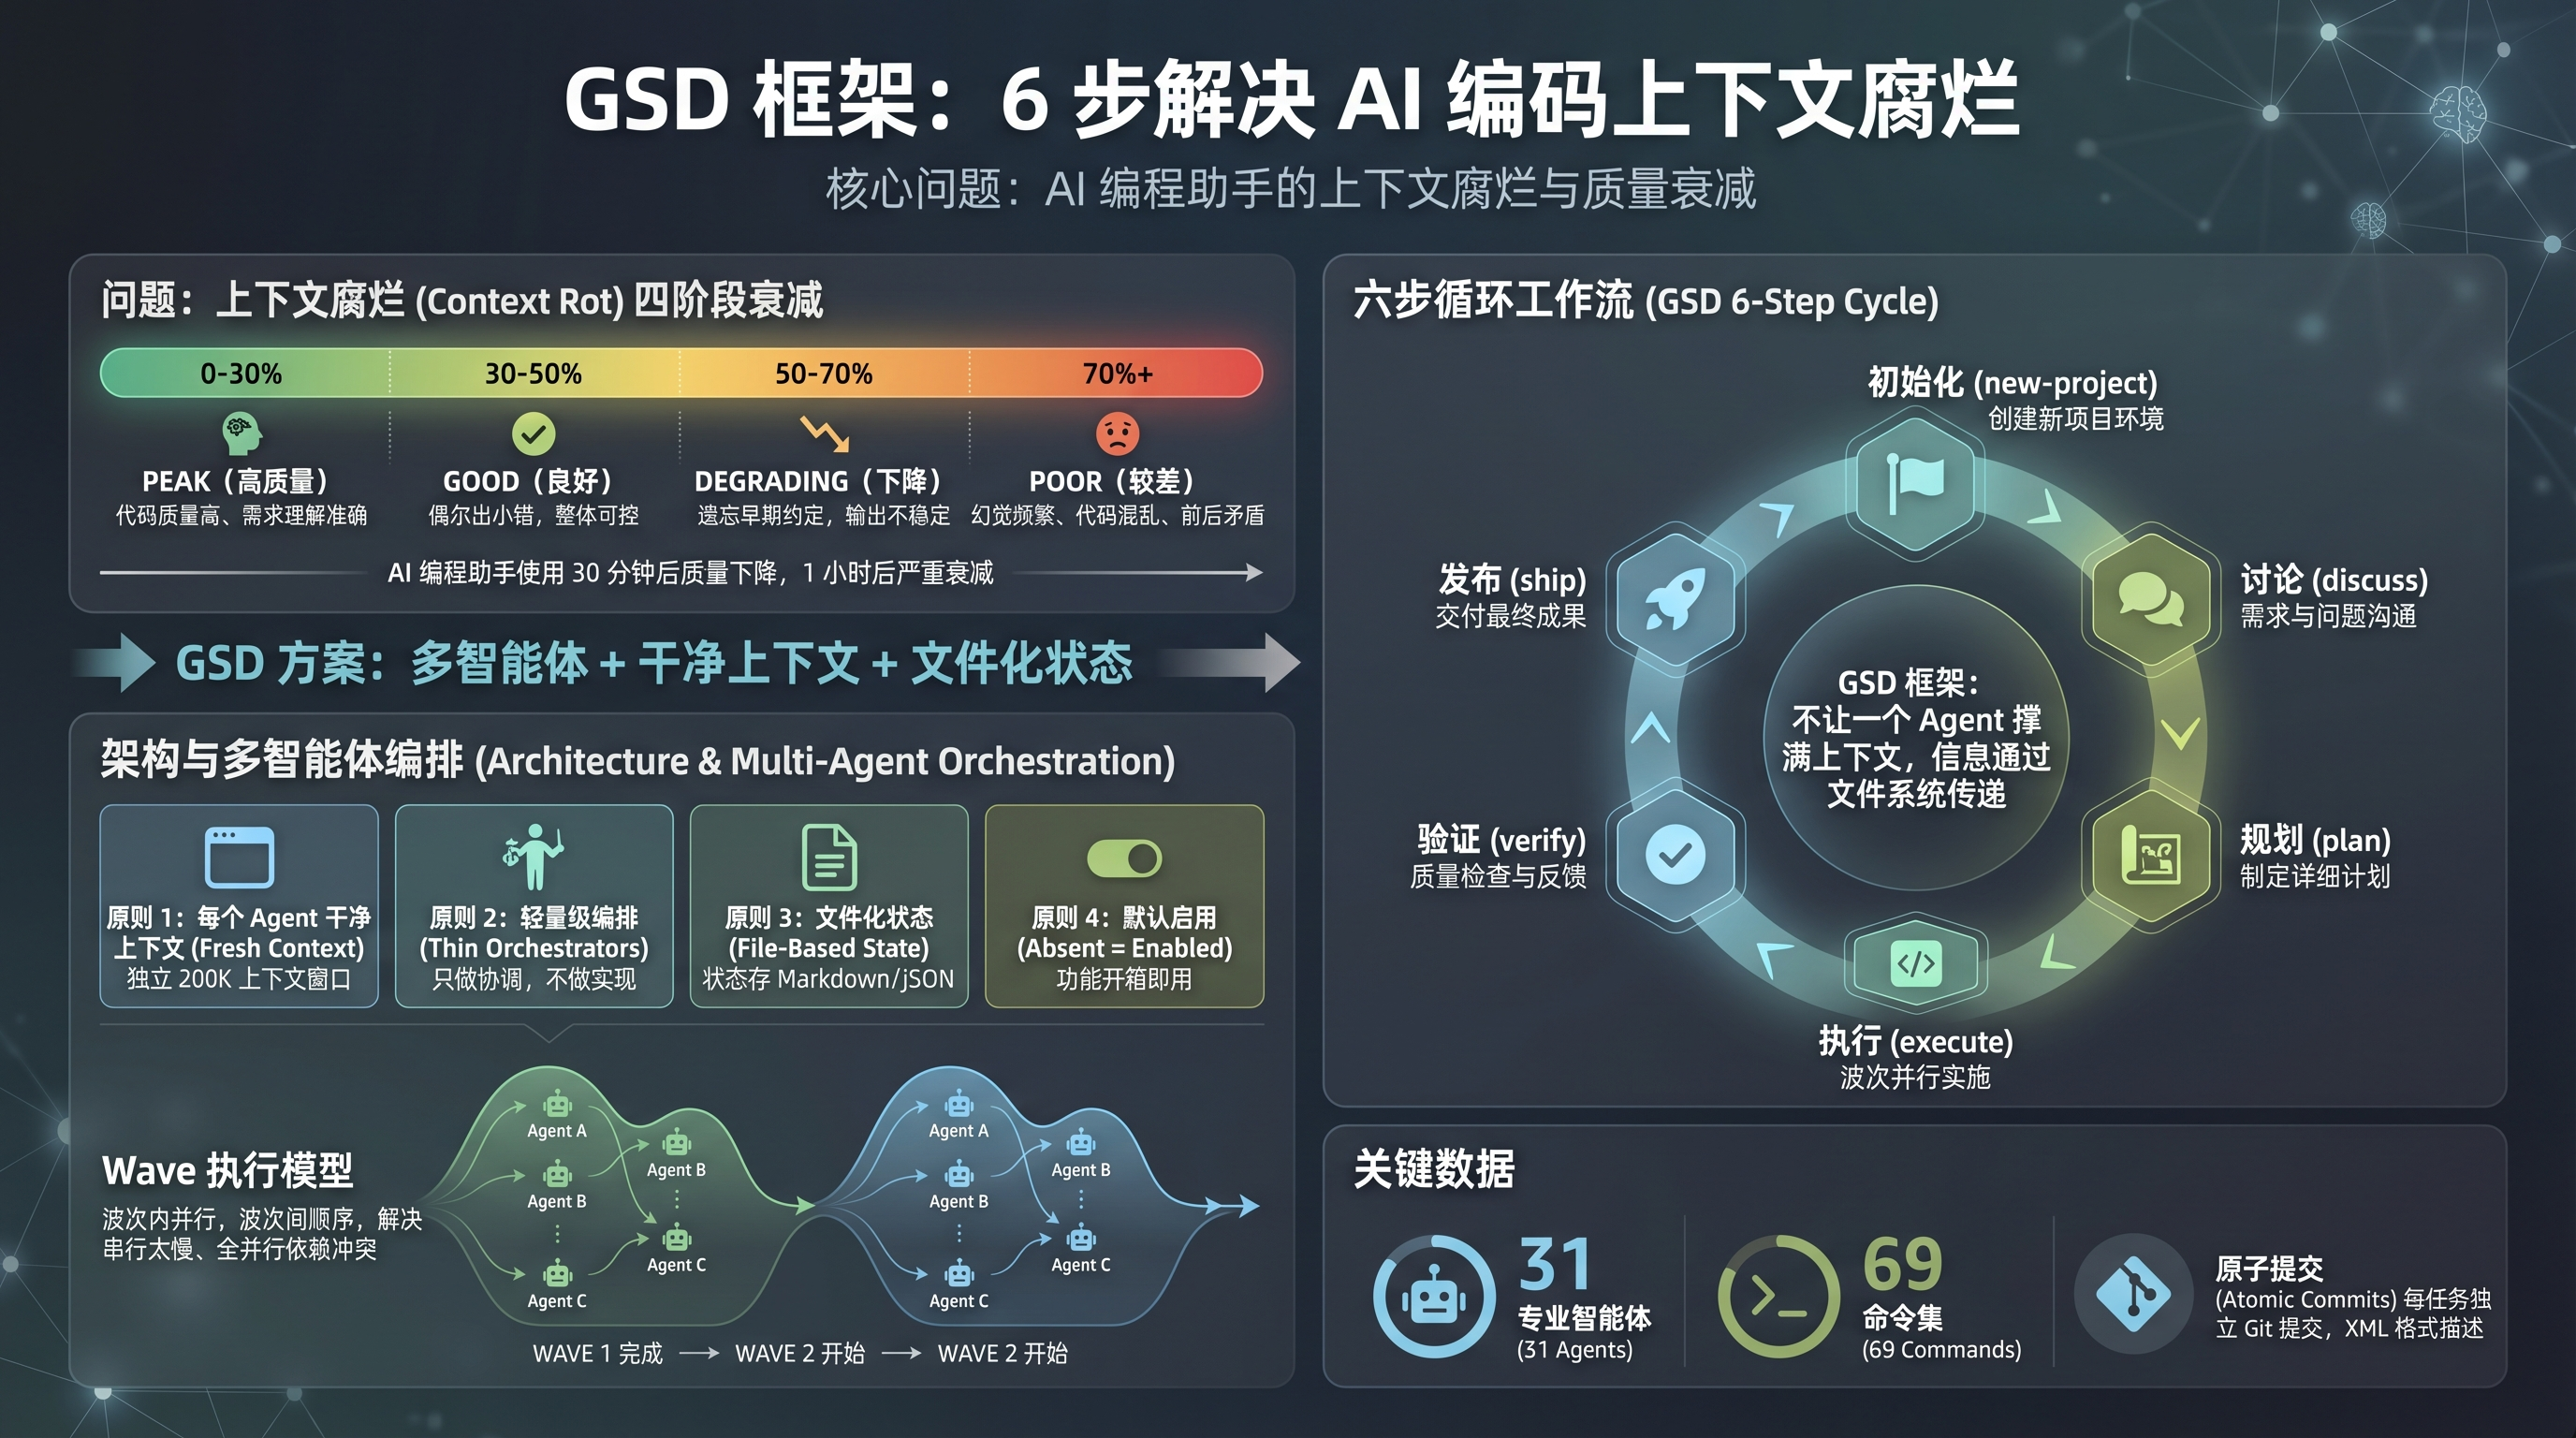
用 AI 编程助手写代码,前 10 分钟生成的代码质量很高。30 分钟后开始出现幻觉,1 小时后连变量命名风格都对不上了。
这不是模型能力不行。根源是 context rot(上下文腐烂):AI 的上下文窗口被信息填满后,生成质量急剧下滑。
GSD(Get Shit Done)就是冲着这个问题来的。它用 31 个专业 Agent、69 个命令和一套文件化状态管理,把 AI 编程从单线程对话拉到多 Agent 并行工程。下面拆解原理和实战用法。
1. 上下文腐烂:AI 编程的隐形瓶颈
1.1 什么是 context rot
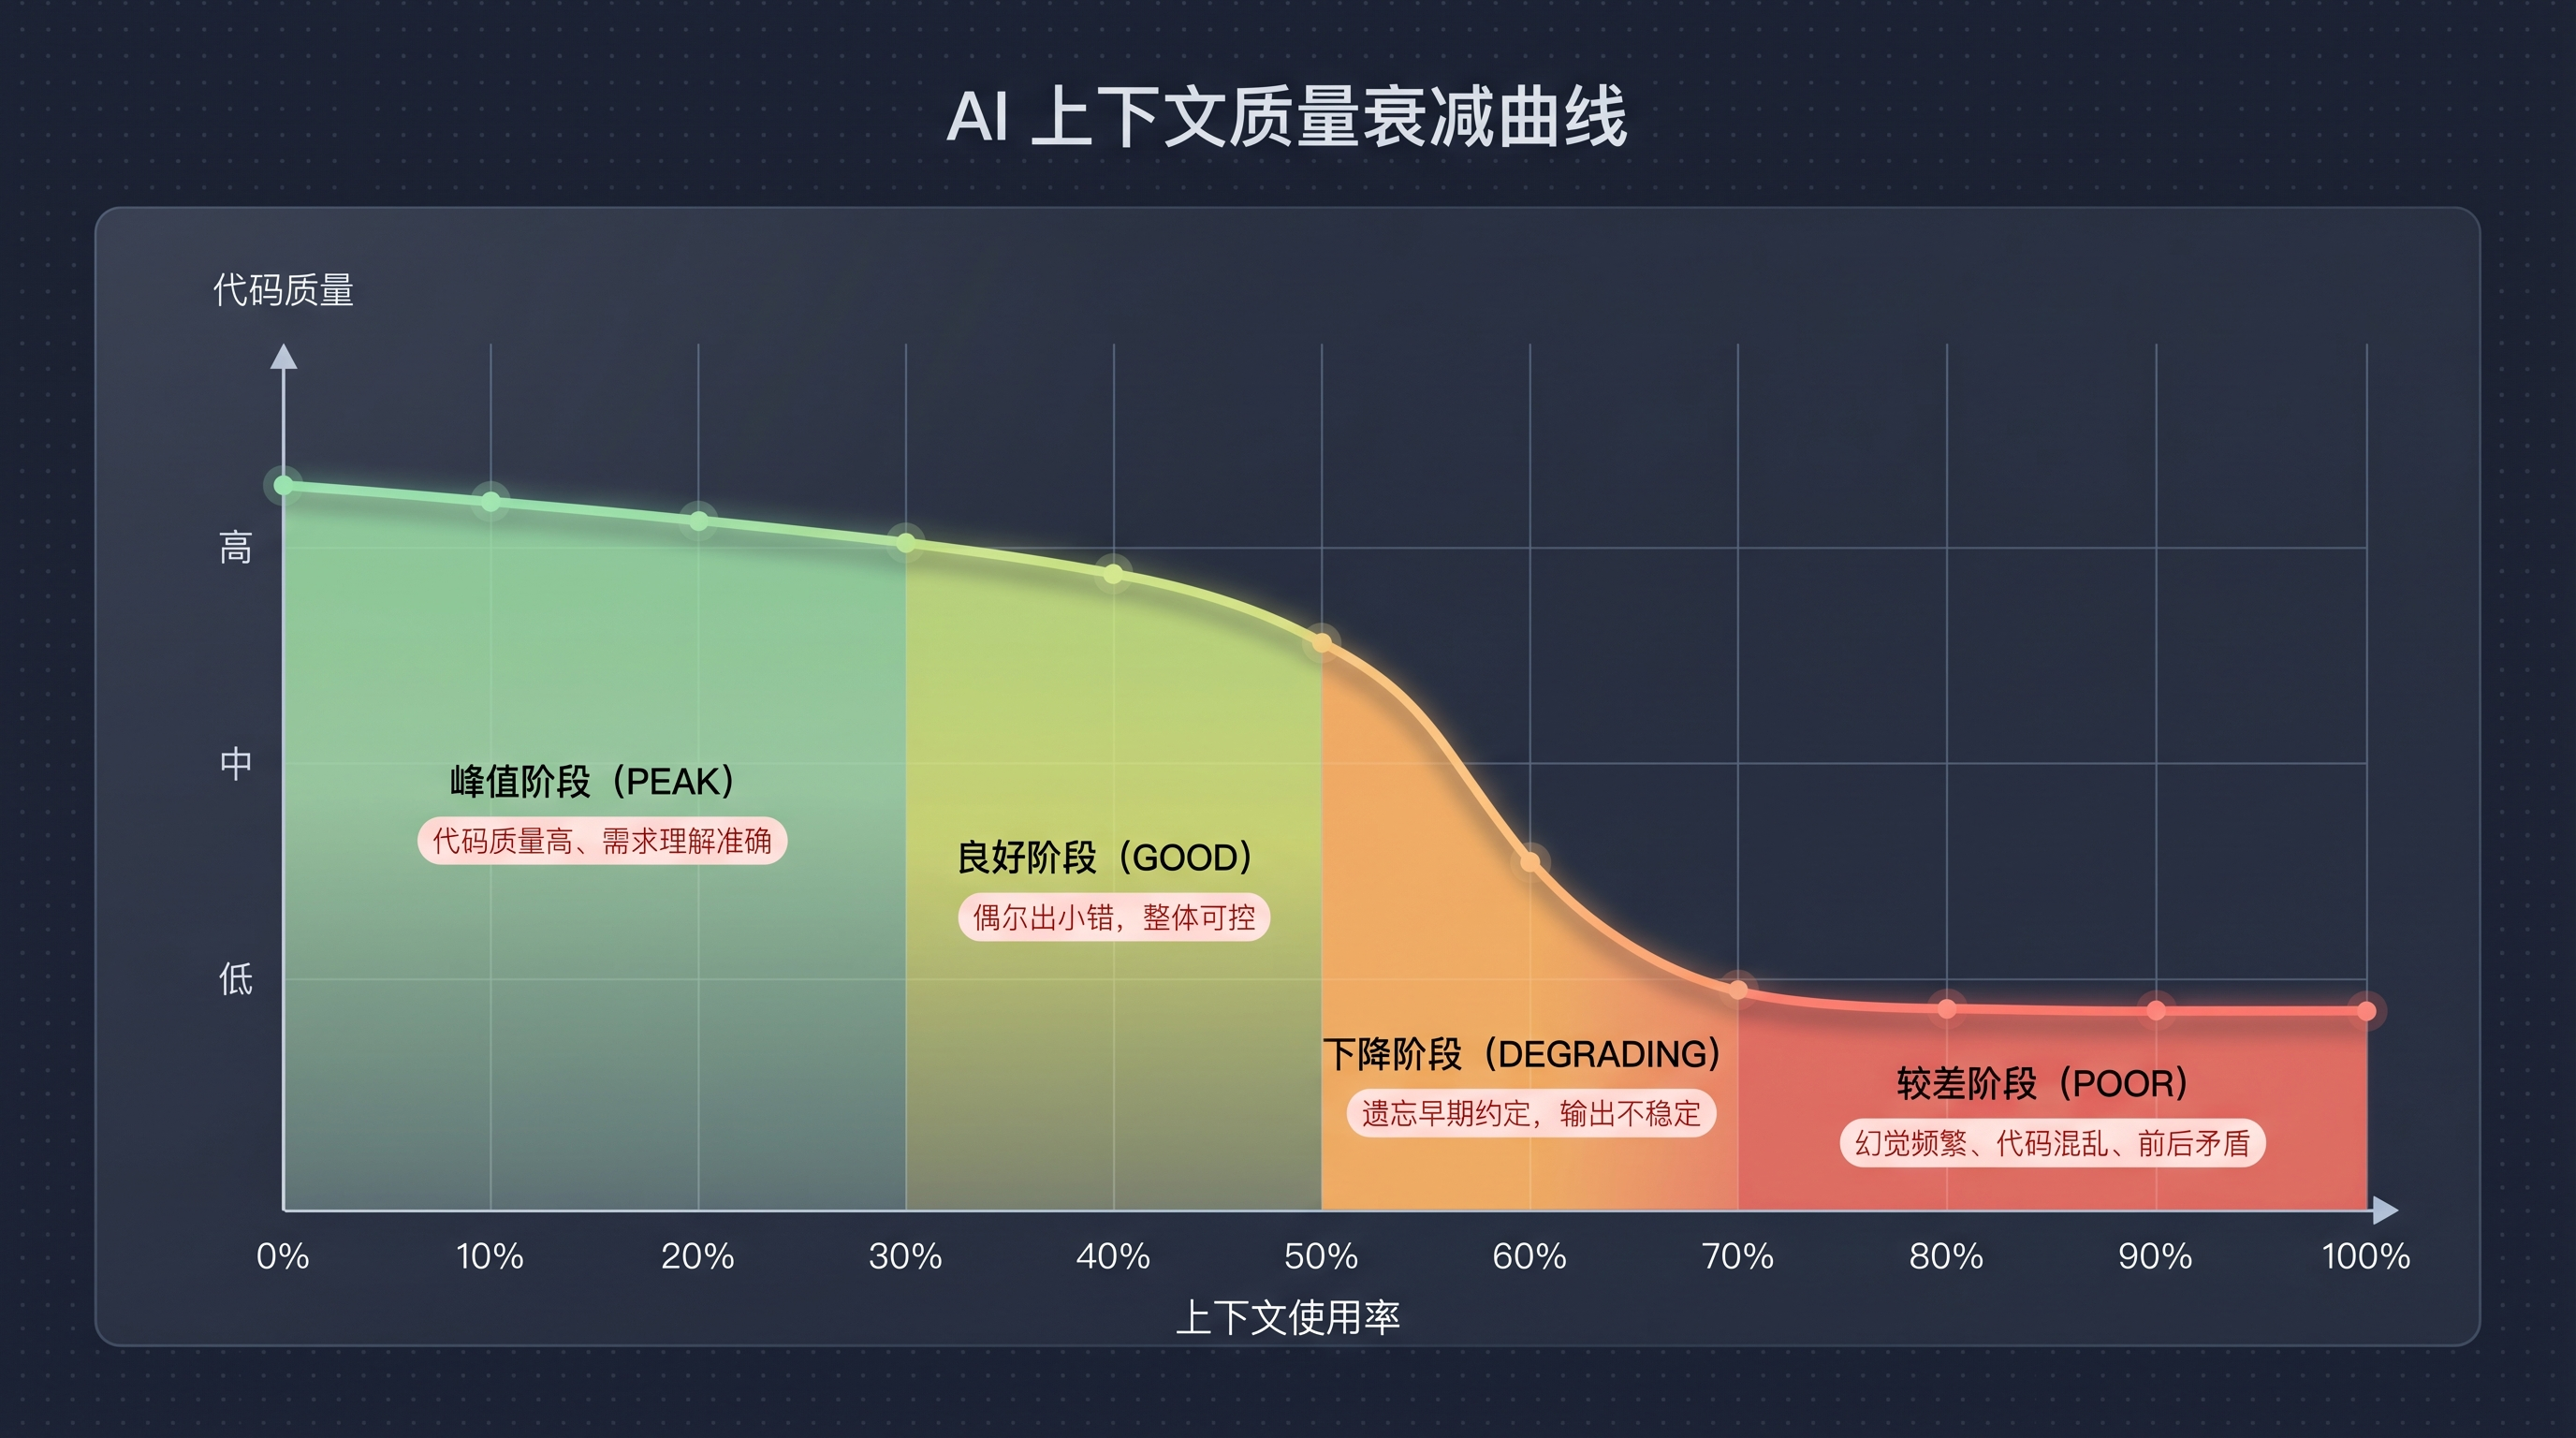
GSD 官方把上下文质量衰减分为四个阶段:
| 上下文使用率 | 质量等级 | 实际表现 |
|---|---|---|
| 0-30% | 峰值(PEAK) | 代码质量高、需求理解准确 |
| 30-50% | 良好(GOOD) | 偶尔出小错,整体可控 |
| 50-70% | 下降(DEGRADING) | 遗忘早期约定,输出不稳定 |
| 70%+ | 较差(POOR) | 幻觉频繁、代码混乱、前后矛盾 |
本质上,大模型的注意力机制在处理长上下文时,对早期信息的权重逐渐降低。你一开始说用 TypeScript + Prisma,到 70% 上下文占用的时候,它可能开始给你写 Python + SQLAlchemy。
传统的应对方式就是手动清空上下文、重新解释项目背景。但这套流程效率很低,而且你自己也容易遗漏关键信息。
GSD 的思路不一样:不让一个 Agent 撑满整个上下文窗口,而是把任务拆分给多个 Agent,每个 Agent 都拿到干净的上下文。信息通过文件系统传递,不通过上下文窗口累积。
1.2 CLI 工具层
GSD 的底层是 gsd-tools.cjs,包含 19 个领域模块,覆盖了从文件操作到安全校验的各种工具函数。这些模块被上层的 Agent 和编排器调用,Agent 不需要自己实现基础能力:读文件、校验路径、解析 JSON 都有现成的工具。
SDK 层(TypeScript 编写)则封装了 PhaseRunner、ContextEngine、PromptBuilder 等核心组件。如果你想在 GSD 的基础上做二次开发,SDK 提供了标准化的扩展接口。
2. GSD 工作流全貌
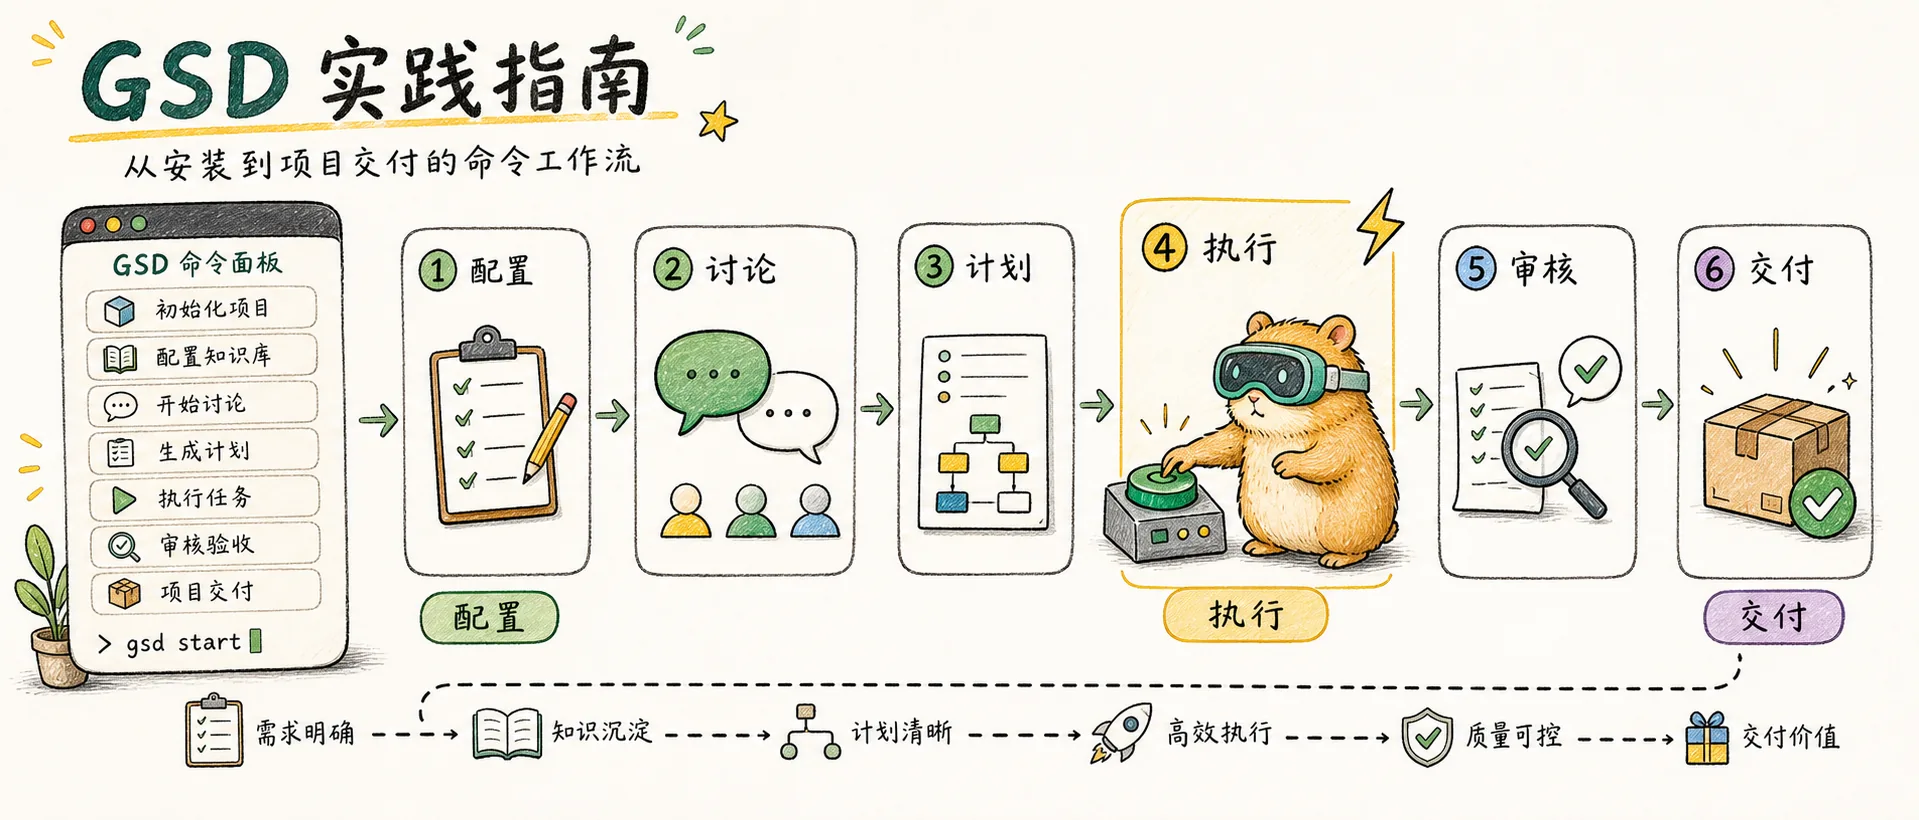
2.1 六步循环
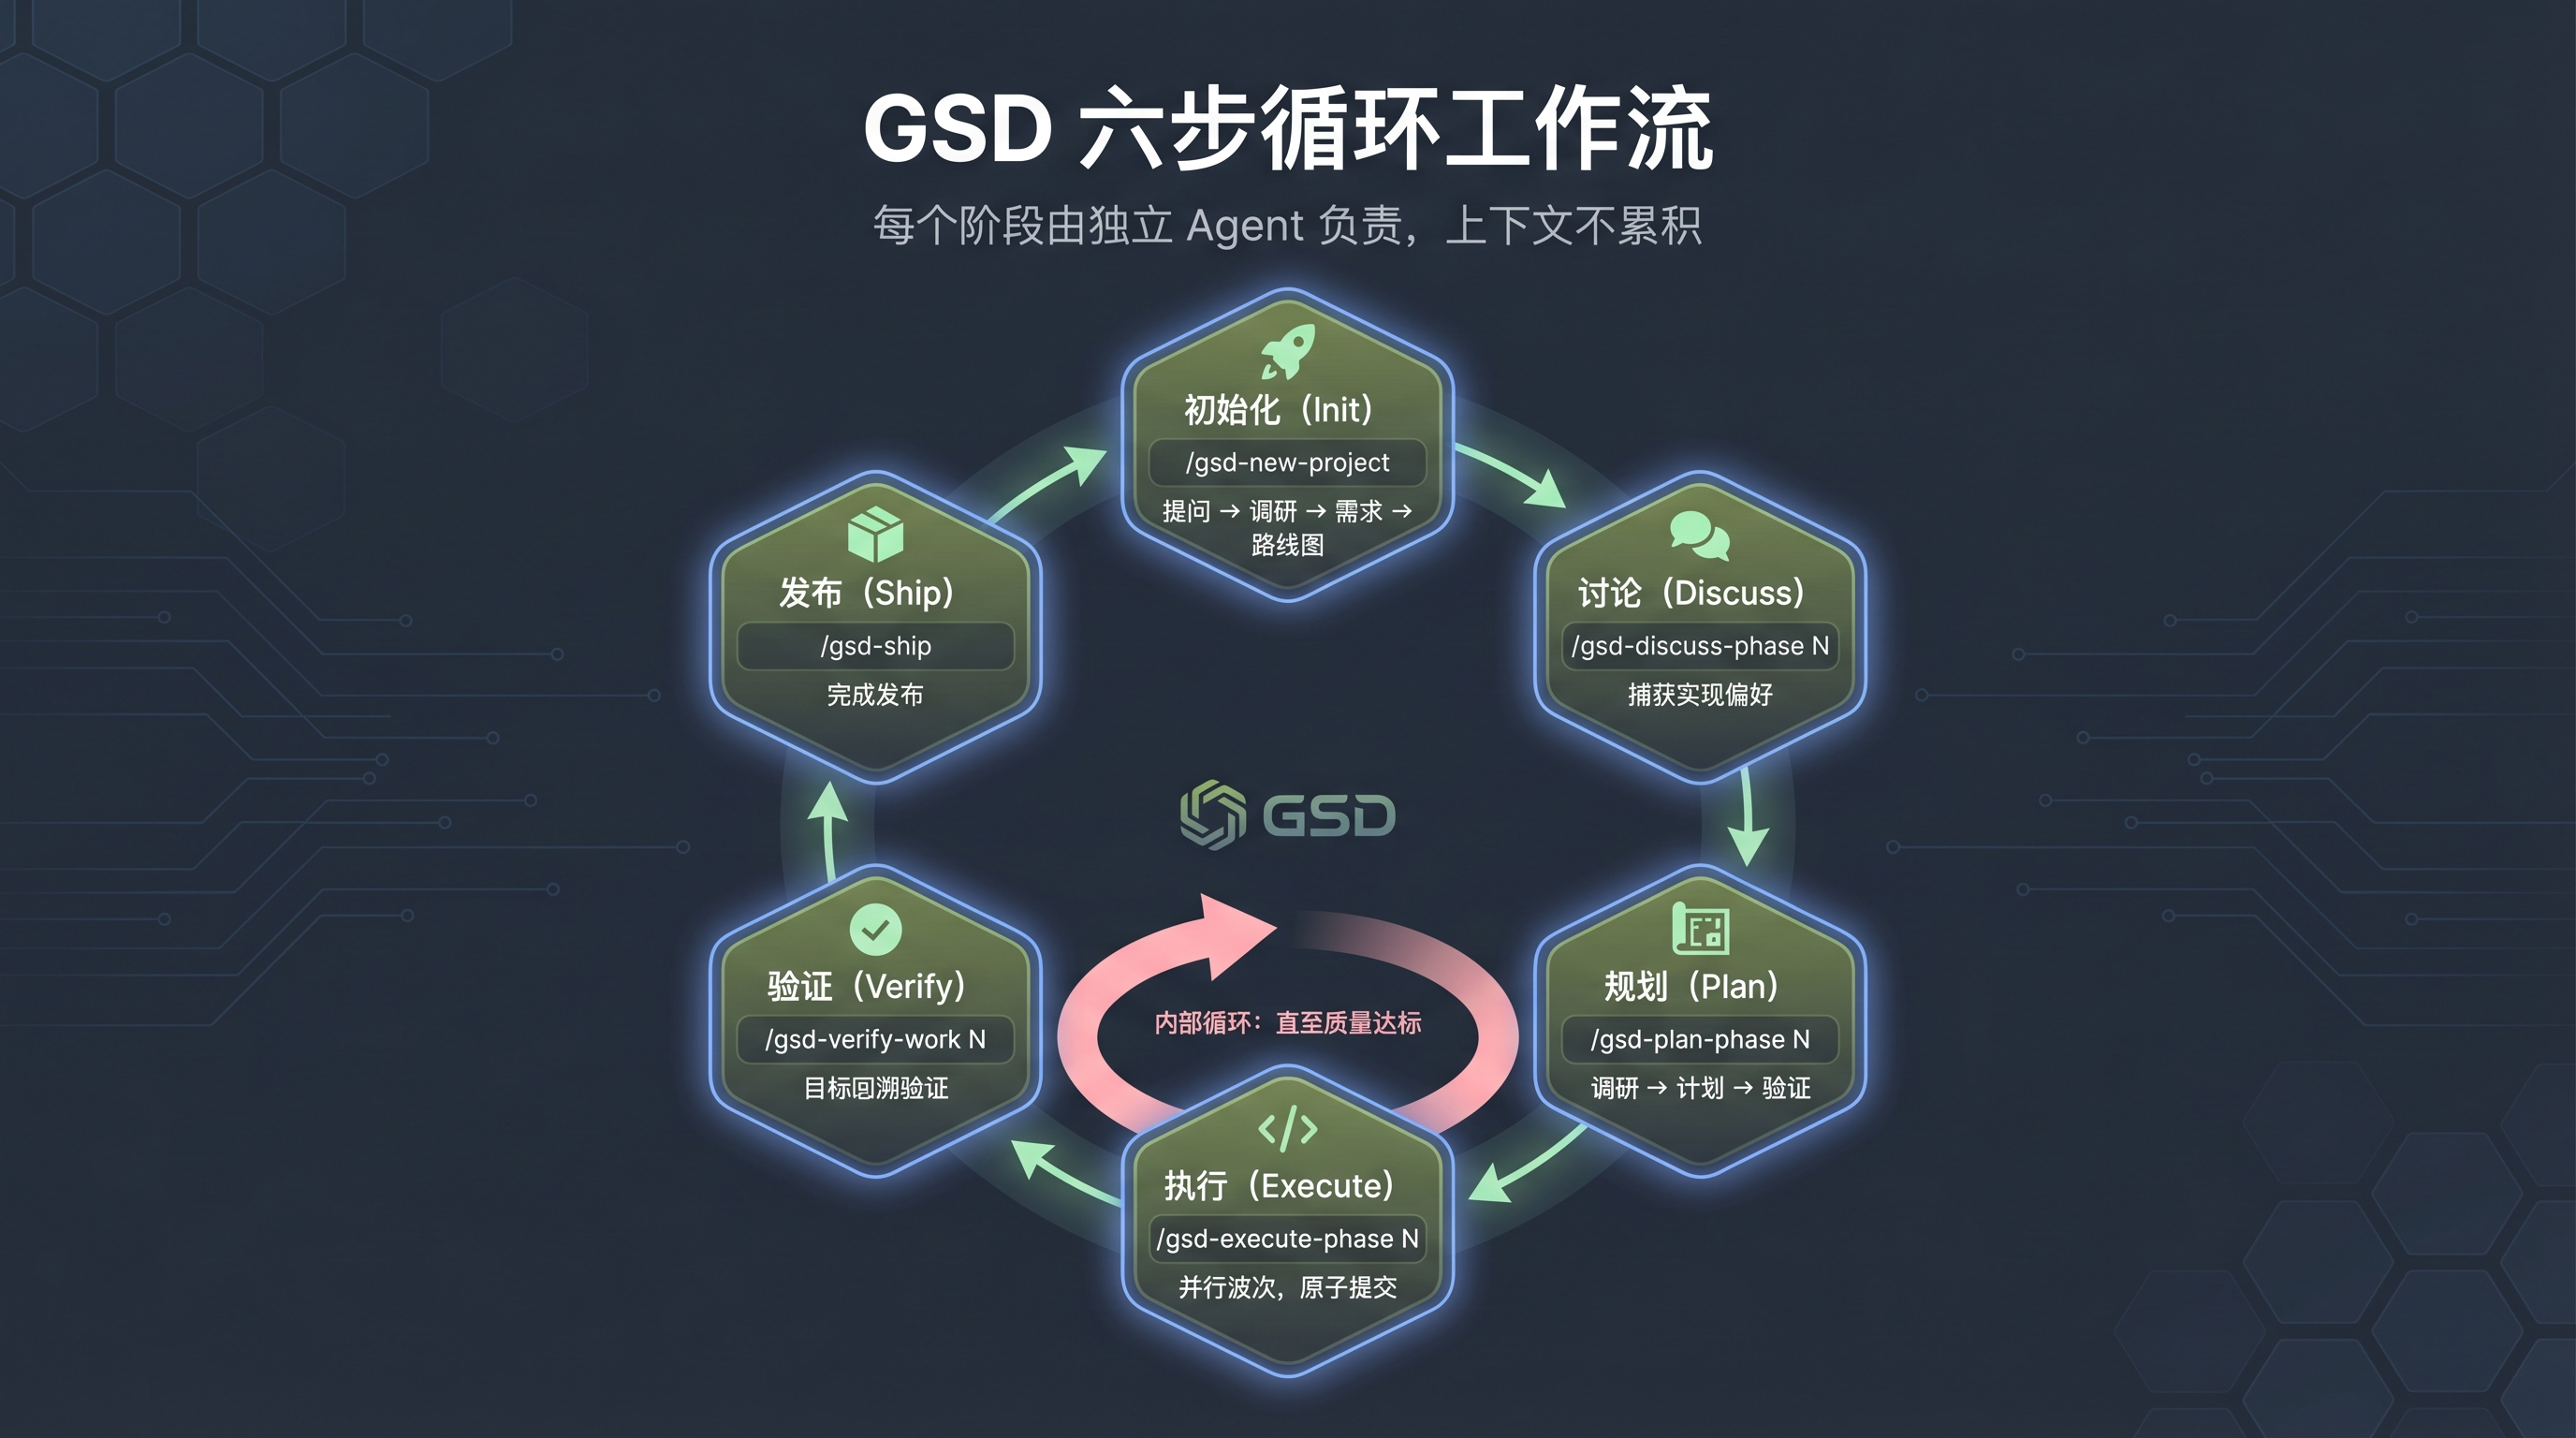
GSD 把一个完整项目的开发周期拆成六个阶段,形成闭环:
代码语言:markdown
AI代码解释
/gsd-new-project      → 初始化(提问 → 调研 → 需求 → 路线图)
/gsd-discuss-phase N  → 讨论(捕获实现偏好)
/gsd-plan-phase N     → 规划(调研 → 计划 → 验证)
/gsd-execute-phase N  → 执行(并行波次,原子提交)
/gsd-verify-work N    → 验证(目标回溯验证)
/gsd-ship → 发布每个阶段结束后自动流转到下一个。执行和验证环节可以循环多次,直到质量达标。这个设计的核心思想是:每个阶段由独立 Agent 负责,上下文不累积。
2.2 四个核心设计原则
GSD 的整个架构建立在四条原则之上:
Fresh Context Per Agent — 每个 Agent 都获得一个干净的上下文窗口,不存在前一个 Agent 的垃圾信息污染下一个的问题。
Thin Orchestrators — 编排器只做协调和调度,不做具体实现。它们本身很轻量,不会吃掉大量上下文空间。
File-Based State — 所有项目状态存在 .planning/ 目录的 Markdown 和 JSON 文件里。人类可以直接阅读、编辑、Git 版本控制。即使所有 Agent 退出,状态也不会丢失。
Absent = Enabled — 功能默认启用,不需要额外配置。减少了初始化的复杂度。
这四条原则是相互支撑的:文件化状态是 Fresh Context 的前提——Agent 能从文件中读到上下文,才不需要在上下文窗口里堆信息。Thin Orchestrator 保证了编排器本身不会成为瓶颈。Absent = Enabled 降低了上手门槛。
3. 多 Agent 编排架构
这是 GSD 区别于其他 AI 编程工具的核心设计。
3.1 Orchestrator → Agent 模式
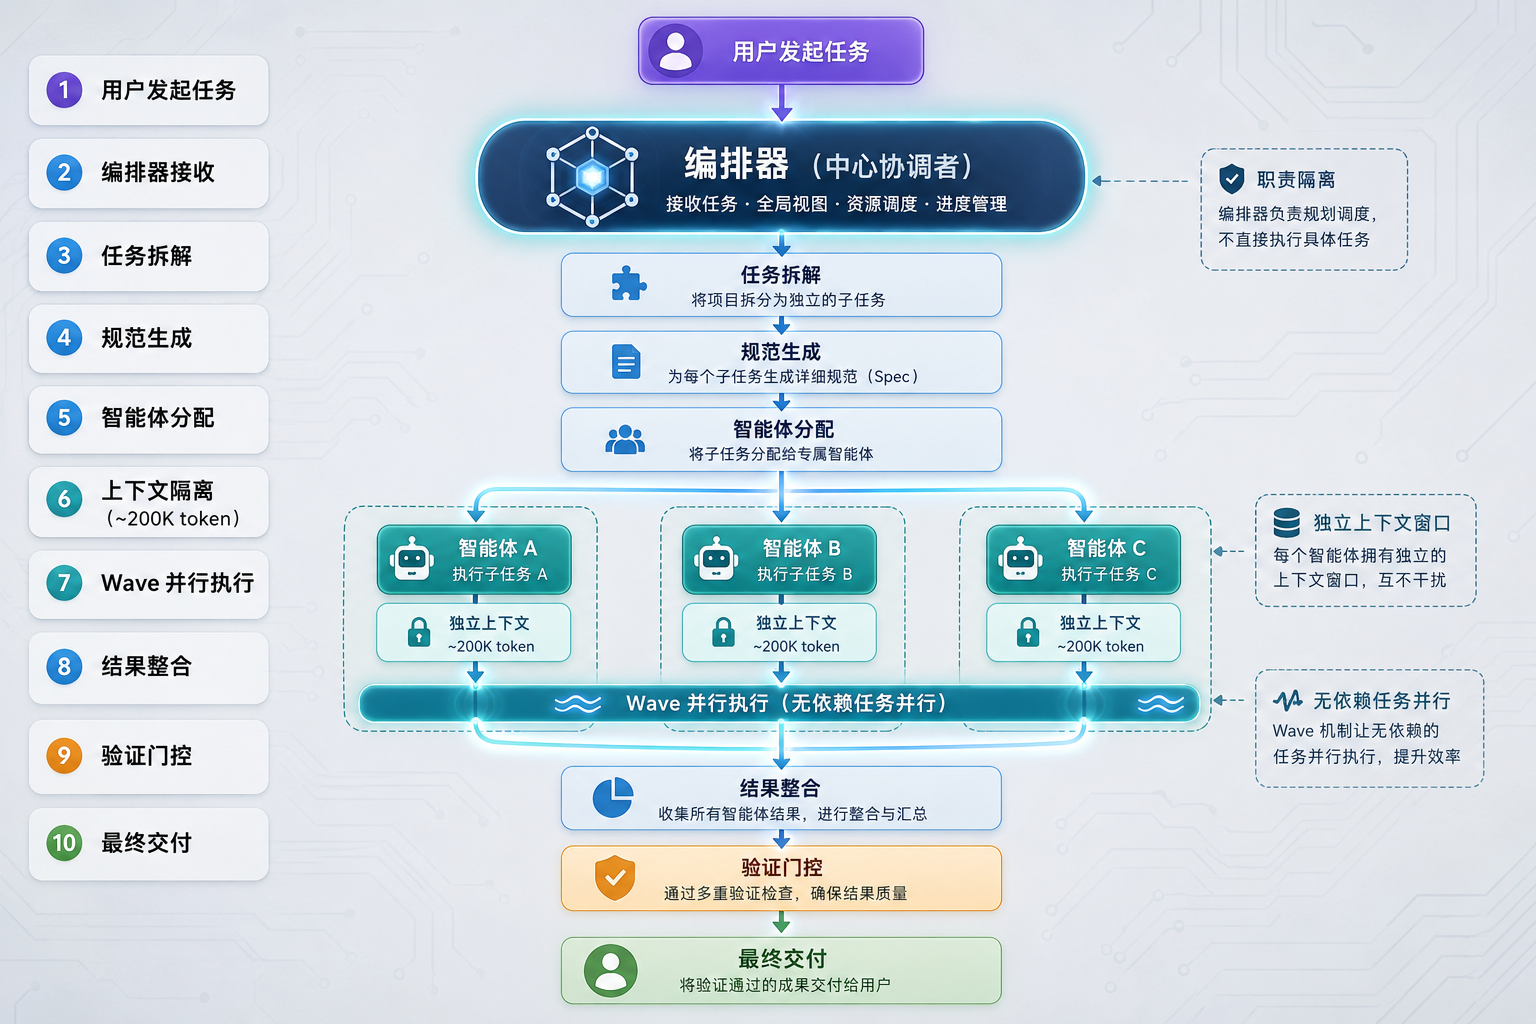
GSD 把协调和执行彻底分开。编排器(Orchestrator)负责调度,Agent 负责干活。
| 阶段 | 编排器职责 | Agent 职责 |
|---|---|---|
| Research | 协调调研方向、呈现结果 | 4 个调研者并行调研技术栈、功能、架构、陷阱 |
| Planning | 验证计划质量、管理迭代 | Planner 创建计划、Checker 验证、循环直到通过 |
| Execution | 分组波次、追踪进度 | 执行器并行实现,各自拥有 200K 干净上下文 |
| Verification | 呈现结果、路由下一步 | 验证器检查代码库是否达成目标 |
Research 阶段的设计值得关注:4 个 Agent 同时出发,分别调研技术栈选型、功能需求、架构方案和已知陷阱。每个 Agent 都是独立的上下文窗口,不会被其他 Agent 的调研方向干扰。
Planning 阶段用了类似对抗训练的思路——一个 Agent 负责写计划,另一个 Agent 专门挑毛病。计划被打回就修改,循环迭代直到 Checker 放行。这个机制避免了自己写的计划自己觉得没问题的盲区。
3.2 Wave 执行模型
执行阶段的并行策略是另一个亮点。计划按依赖关系分组为波次(Wave)。同一波次内并行执行,波次之间顺序执行:
代码语言:markdown
AI代码解释
Wave 1 (parallel)          Wave 2 (parallel)          Wave 3
Plan 01  Plan 02    →    Plan 03  Plan 04    →    Plan 05
User     Product         Orders   Cart              Checkout
Model    Model           API      API               UI
Wave 1 创建 User Model 和 Product Model,两个没有依赖关系,并行跑。Wave 2 依赖 Wave 1 的结果,所以排在第二波。Wave 3 的 Checkout 依赖前面所有组件,排在收尾。
这直接解决了两个矛盾:串行执行太慢,全并行又会导致依赖冲突。
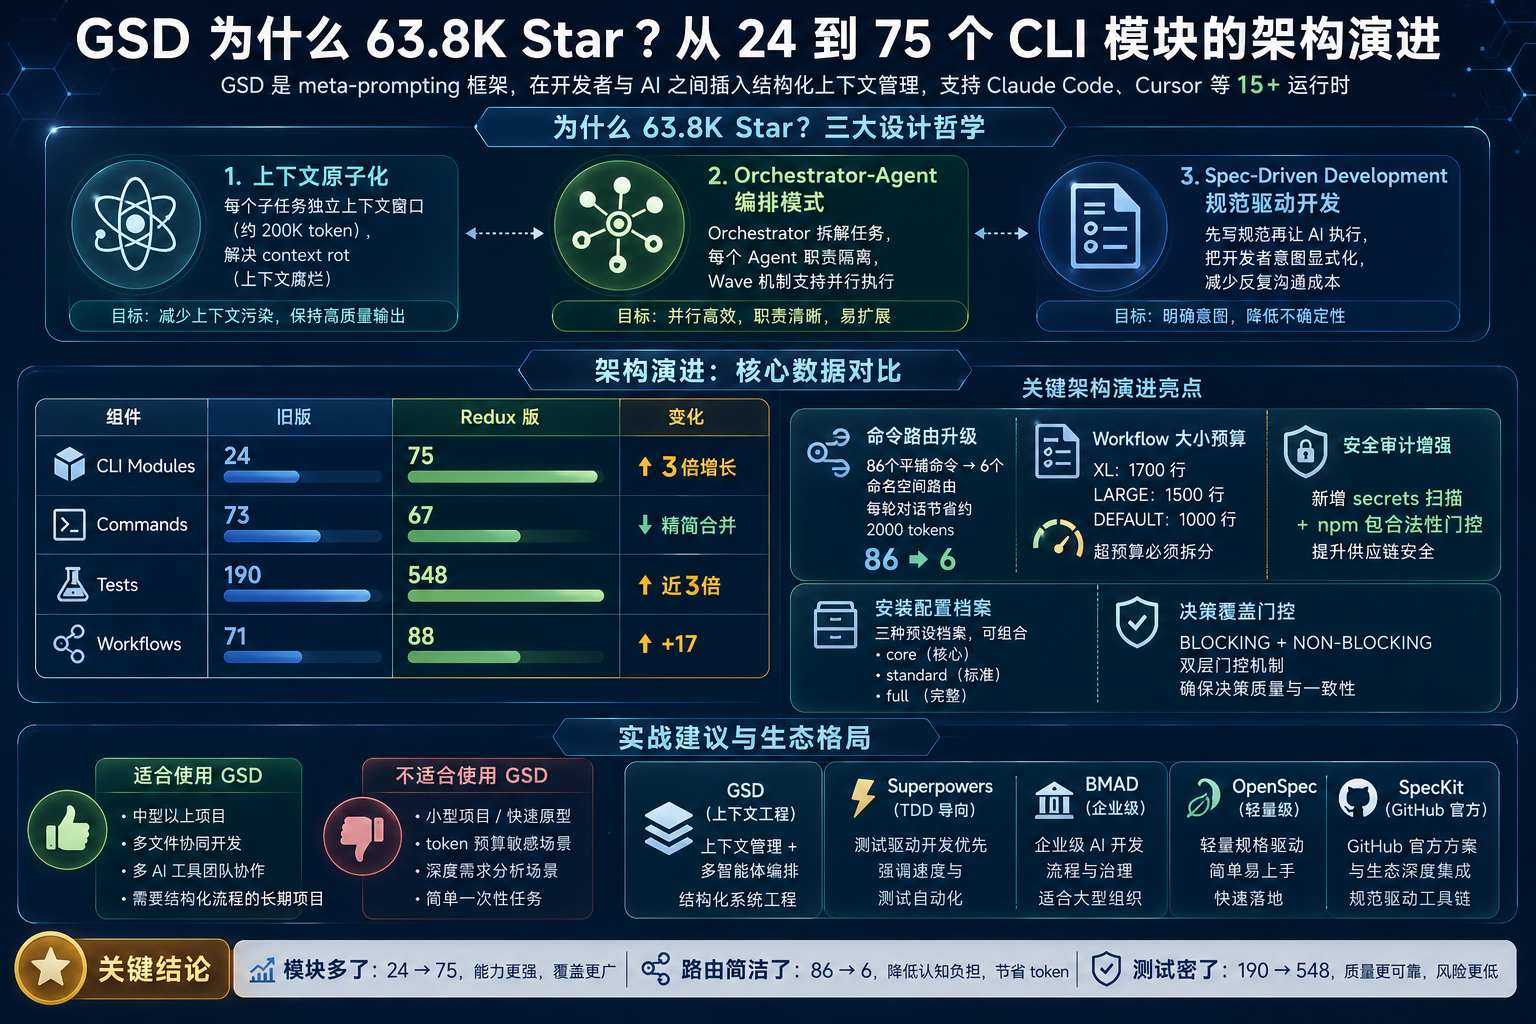
你有没有这种体验:用 AI 编码助手写代码,刚开始几轮对话质量很高,越往后越离谱——明明说了不要用 any,它照用;前边刚定义好的接口,到后边就忘了。
这不是模型变笨了。是上下文窗口被塞满后的必然结果。
1. 为什么 63.8K Star?GSD 做对了什么
先说结论:GSD 踩中的不是某个技术风口,而是一个几乎所有 AI 编码用户都会遇到的痛点。
腾讯新闻上有一篇关于 GSD 的报道,里面有句话说得挺到位:别再迷信 AI 一口气把整个项目写完了。先拆,拆小,拆清楚,再让它一段段做。
这就是 GSD 的核心设计哲学。它的官方定位是 meta-prompting 框架——不是替你写代码,而是在你和 AI 之间插一层结构化的上下文管理。这个框架支持 Claude Code、OpenCode、Gemini CLI、Kilo、Codex、Copilot、Cursor、Windsurf 等 15+ 运行时,不绑定单一工具。
具体来说,它做对了三件事。
上下文原子化
GSD 把一个大项目拆成一个个子任务,每个子任务在独立的上下文窗口中执行。这意味着每个子任务都能获得约 200K token 的完整上下文空间,而不是和其他任务挤在一个不断膨胀的会话里。
CSDN 上有篇分析文章用了个术语叫上下文原子化——把臃肿的全局上下文拆成原子级别的独立单元,每个单元都在干净的环境里运行。
这解决了什么问题?一句话:context rot(上下文腐烂)。AI 编码会话越长,生成质量越差。CSDN 上有篇文章标题很直白:通过上下文原子化治理大模型代码生成的”注意力崩塌”。这不是偶尔发生的 bug,而是大模型上下文窗口有限性导致的结构性问题。不管模型参数量怎么涨,窗口大小总有上限。GSD 不是在治标,而是在架构层面绕开了这个问题。
Orchestrator-Agent 编排模式
拆完任务,还得有人协调。GSD 用的是 Orchestrator(编排器)加 Agent(执行器)的模式:Orchestrator 负责拆解任务和分配,每个 Agent 只负责自己那一小块。
这个模式的好处是职责隔离。每个 Agent 的上下文里只有和它相关的信息,不会被其他任务的上下文污染。Wave 机制还允许无依赖的任务并行执行——多文件复杂模块的生成速度,比单 Agent 串行快不少。
Spec-Driven Development(规范驱动开发)
GSD 强制要求先写规范(spec),再让 AI 按规范执行。这不是额外的文档负担,而是把开发者的意图显式化。当 AI 在一个新上下文中开始工作时,spec 就是它的”记忆”——它不需要从零理解项目,直接按照 spec 行事。
腾讯新闻那篇文章里还有一句说得很好:真正做项目时,问题往往不在于你会不会写一句漂亮 prompt,而在于你有没有办法把开发流程收拾得足够清楚,让 AI 每次都处在一个相对干净、稳定的工作区里。
这三点加在一起,解释了为什么它能从一堆 SDD 框架里脱颖而出。不是因为它功能多,而是因为它精准地解决了一个高频痛点。
MCP Token 预算意识
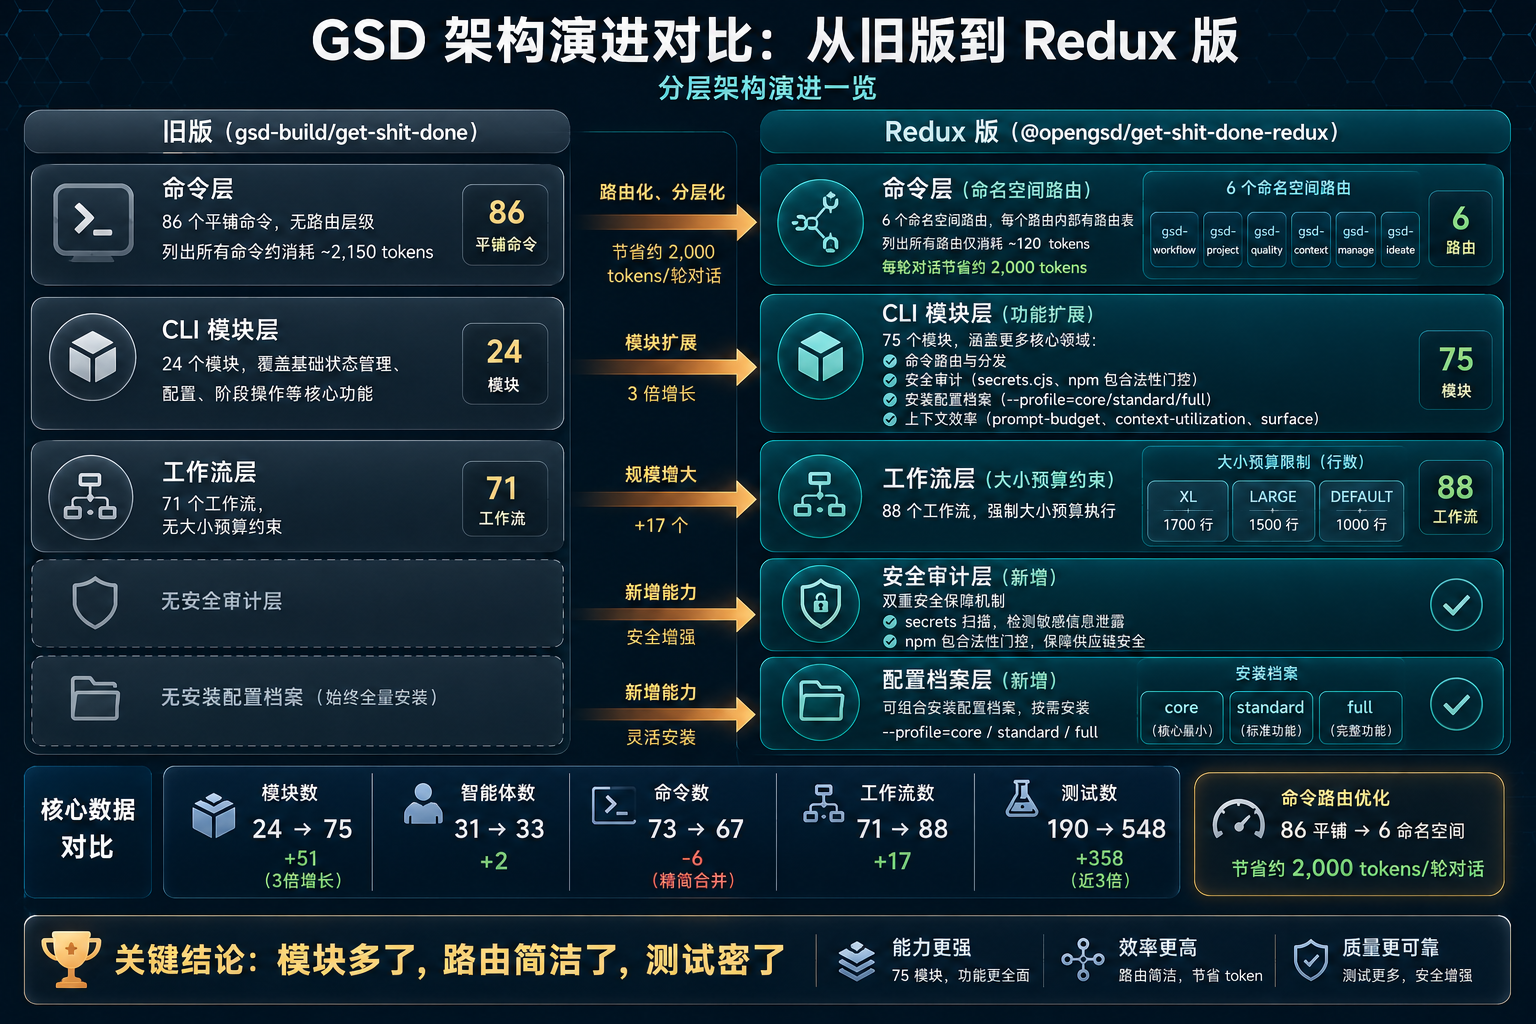
Redux 版的架构文档里有一组常被忽略的数据:重量级 MCP 服务器(如 browser/playwright)每个可能消耗 20K+ tokens/轮。如果同时启用多个 MCP 服务器,光 MCP 的 token 开销就能吃掉上下文预算的一大块。
这解释了为什么两阶段路由不只是”代码整洁”的问题,而是直接影响成本。当你只展示 6 个命名空间而不是 86 个平铺技能时,省下来的不只是展示开销,还有后续调用中 MCP 服务器的触发次数。架构决策和 token 经济学是绑定的,这是 Redux 版在设计上比旧版成熟的地方。
和其他框架的关系
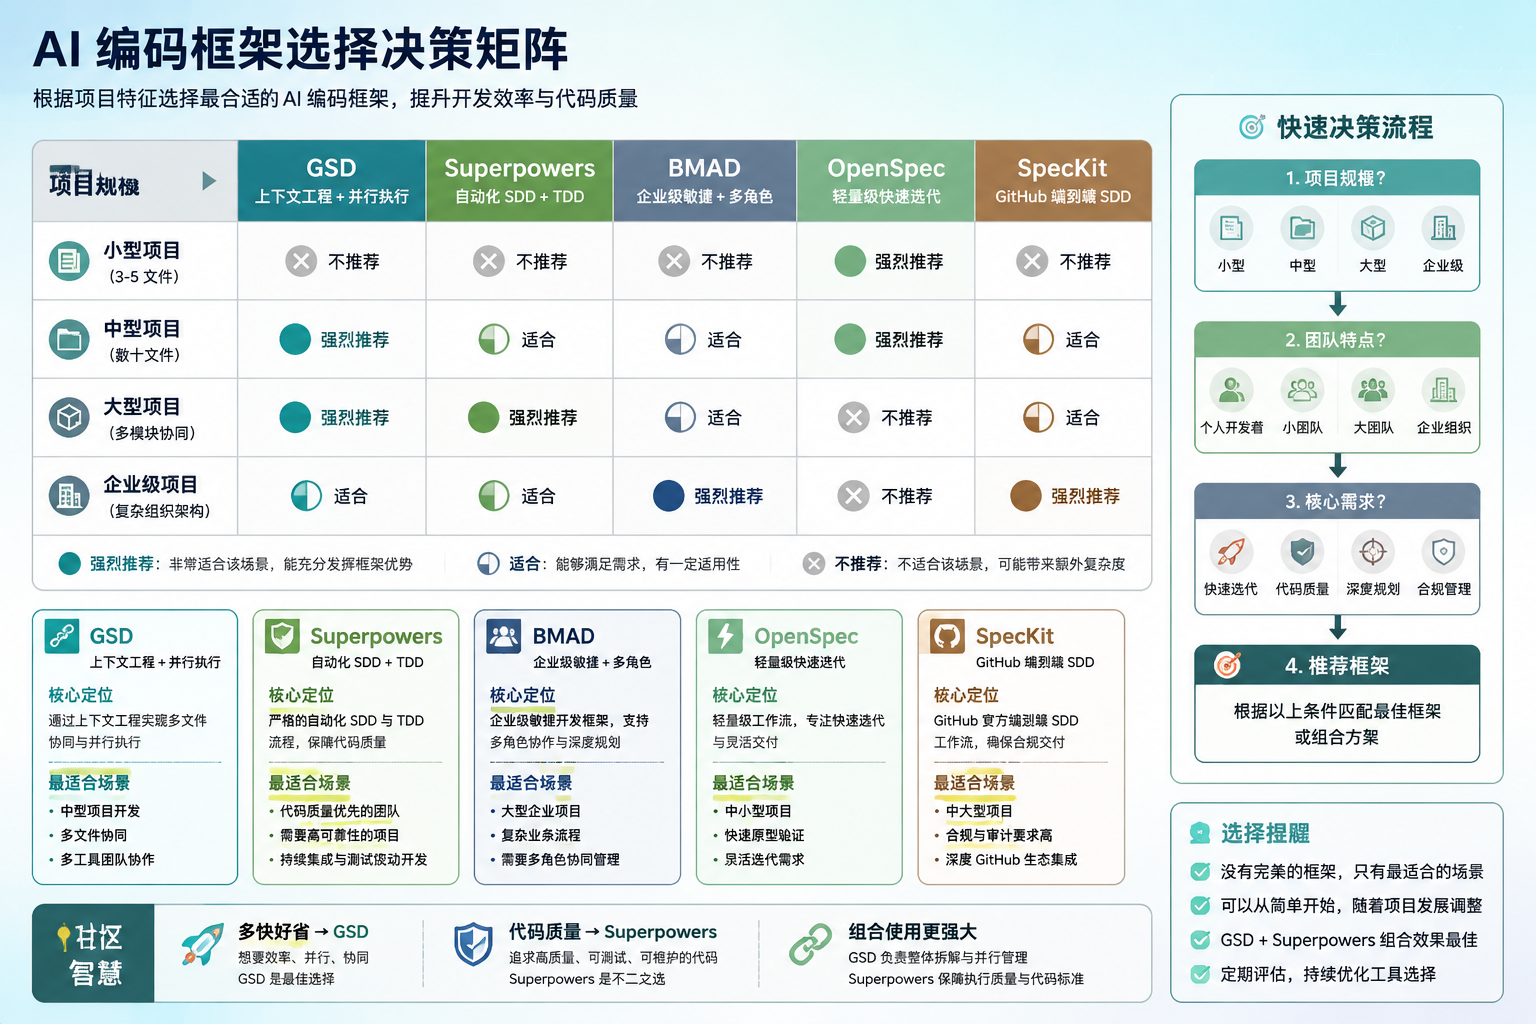
根据社区的多篇横评,目前的 SDD 框架格局大致是这样:
| 框架 | 核心定位 | 适合场景 |
|---|---|---|
| GSD | 上下文工程 + 并行执行 | 中型项目、多文件协同 |
| Superpowers | 严格自动化 SDD + TDD | 代码质量优先的团队 |
| BMAD | 企业级敏捷开发 + 多角色 | 大型企业、深度规划 |
| OpenSpec | 轻量级快速迭代 | 中小型项目 |
| SpecKit | GitHub 官方端到端 SDD | 中大型、合规项目 |
流水理鱼的一篇横评里有个挺实用的总结:想要多快好省 → 用 GSD;追求代码质量 → 用 Superpowers。
更有意思的是,两者其实可以互补。理论上可以用 GSD 管理项目整体拆解(解决”怎么拆”的问题),用 Superpowers 的 TDD 技能处理每个子任务的执行质量(解决”怎么做”的问题)。Qiita 上的日文指南也提到了这种组合的可能性。这种搭配在大型项目里可能会产生不错的效果。
安装与配置
安装
npx @opengsd/gsd-core@latest安装器会提示你选择:
- 运行时 — Claude Code、OpenCode、Gemini CLI 或全部
- 位置 — 全局(所有项目)或本地(当前项目)
安装后在运行时中输入 /gsd:help 验证安装成功。
推荐:跳过权限模式
GSD 设计为无摩擦自动化。推荐以下方式运行 Claude Code:
claude --dangerously-skip-permissions如果不想用这个标志,可以在 .claude/settings.json 中配置细粒度权限。
更新
/gsd:updateGSD 更新非常频繁(TÂCHES 几乎每天推送 15-20 次更新),建议定期运行此命令保持最新版本。
完整命令参考
GSD 的所有交互都通过 /gsd: 前缀的斜杠命令完成。以下按功能分类列出完整命令。
核心工作流命令
这五个命令构成 GSD 的主循环,按顺序使用。
| 命令 | 说明 |
|---|---|
/gsd:new-project | 初始化项目。系统持续提问直到理解你的想法,然后研究、提取需求、创建路线图 |
/gsd:discuss-phase [N] | 讨论第 N 阶段的灰色地带。捕获你的实现偏好,为规划提供方向 |
/gsd:plan-phase [N] | 为第 N 阶段创建原子任务计划。包含研究、规划、验证三个子步骤 |
/gsd:execute-phase <N> | 执行第 N 阶段。子代理并行实现任务,每个任务独立提交 |
/gsd:verify-work [N] | 验证第 N 阶段的交付物。引导你逐一确认,自动诊断问题 |
[N]表示可选参数——省略时系统会自动检测当前阶段。<N>表示必填参数。
里程碑管理
| 命令 | 说明 |
|---|---|
/gsd:audit-milestone | 审计当前里程碑进度——检查所有阶段状态,识别未完成项 |
/gsd:complete-milestone | 归档当前里程碑,标记版本,准备进入下一个周期 |
/gsd:new-milestone [name] | 创建新里程碑。可选提供名称,系统会基于已完成工作规划下一阶段 |
阶段管理
| 命令 | 说明 |
|---|---|
/gsd:add-phase | 在路线图末尾添加新阶段 |
/gsd:insert-phase [N] | 在指定位置插入紧急阶段,后续阶段自动重新编号 |
/gsd:remove-phase [N] | 移除指定阶段,级联删除所有相关产出文件 |
/gsd:list-phase-assumptions [N] | 列出指定阶段的所有假设和依赖,帮助识别潜在风险 |
Quick Mode 与工具
| 命令 | 说明 |
|---|---|
/gsd:quick [--full] | 快速模式——跳过研究、计划检查和验证,适合小任务。--full 启用完整保障 |
/gsd:debug [desc] | 启动隔离的调试子代理。可选描述问题,系统会假设→取证→解决 |
/gsd:add-todo [desc] | 记录想法到待办列表,不修改路线图 |
/gsd:check-todos | 查看当前待办列表 |
/gsd:map-codebase | 分析已有代码库——技术栈、架构、约定、潜在问题 |
Session 与配置管理
| 命令 | 说明 |
|---|---|
/gsd:pause-work | 暂停工作。保存当前状态到 STATE.md,方便下次恢复 |
/gsd:resume-work | 恢复工作。从 STATE.md 读取上次状态,继续上次中断的地方 |
/gsd:progress | 查看项目整体进度——完成阶段数、当前位置、待处理项 |
/gsd:help | 显示所有可用命令和简要说明 |
/gsd:settings | 查看和修改 GSD 配置 |
/gsd:set-profile | 切换模型配置(quality / balanced / budget) |
/gsd:update | 更新 GSD 到最新版本 |
配置详解
模型配置
GSD 支持三种模型配置,通过 /gsd:set-profile 切换:
| 配置 | 规划 | 执行 | 验证 | 适用场景 |
|---|---|---|---|---|
| quality | Opus | Opus | Sonnet | 复杂项目、关键功能、首次使用 |
| balanced (默认) | Opus | Sonnet | Sonnet | 日常开发、多数场景的最佳平衡 |
| budget | Sonnet | Sonnet | Haiku | 简单功能、预算敏感、快速迭代 |
核心设置
通过 /gsd:settings 查看和修改以下配置:
| 设置 | 默认值 | 说明 |
|---|---|---|
mode | balanced | 模型配置选择 |
depth | standard | 研究深度:quick(快速)/ standard(标准)/ deep(深入) |
git.branching_strategy | feature | Git 分支策略:feature(按功能分支)/ phase(按阶段分支)/ none |
工作流开关
以下代理可以单独开关,在速度和质量之间取舍:
| 开关 | 默认 | 说明 |
|---|---|---|
research | 开 | 规划前是否进行自动研究 |
plan_check | 开 | 计划创建后是否自动验证 |
verifier | 开 | 执行后是否自动验证 |
auto_advance | 关 | 阶段完成后是否自动进入下一阶段 |
关闭
research和plan_check可以显著加快速度,但可能降低规划质量。建议在熟悉项目后再考虑关闭。
产出文件结构
GSD 的所有状态和产出都保存在 .planning/ 目录下。理解这个结构有助于调试和手动干预。
项目级文件
| 文件 | 作用 | 创建时机 |
|---|---|---|
PROJECT.md | 项目愿景和范围 | new-project |
REQUIREMENTS.md | 分版本的需求文档,带阶段追溯 | new-project |
ROADMAP.md | 阶段规划和进度 | new-project |
STATE.md | 当前状态——决策、阻碍、位置 | new-project,持续更新 |
阶段级文件
每个阶段会产生以下文件(以阶段 1 为例):
| 文件 | 作用 | 创建时机 |
|---|---|---|
01-CONTEXT.md | 讨论阶段的决策记录 | discuss-phase 1 |
01-RESEARCH.md | 研究发现和技术调查 | plan-phase 1 |
01-01-PLAN.md | 第一个原子任务计划 | plan-phase 1 |
01-02-PLAN.md | 第二个原子任务计划 | plan-phase 1 |
01-01-SUMMARY.md | 第一个计划的执行记录 | execute-phase 1 |
01-02-SUMMARY.md | 第二个计划的执行记录 | execute-phase 1 |
01-VERIFICATION.md | 自动验证结果 | execute-phase 1 |
01-UAT.md | 用户验收测试记录 | verify-work 1 |
目录结构示例
.planning/├── PROJECT.md├── REQUIREMENTS.md├── ROADMAP.md├── STATE.md├── research/│ ├── tech-stack.md│ ├── features.md│ ├── architecture.md│ └── pitfalls.md├── 01-CONTEXT.md├── 01-RESEARCH.md├── 01-01-PLAN.md├── 01-02-PLAN.md├── 01-01-SUMMARY.md├── 01-02-SUMMARY.md├── 01-VERIFICATION.md├── 01-UAT.md├── 02-CONTEXT.md├── 02-RESEARCH.md├── 02-01-PLAN.md│ ...└── todos.md实战工作流演示
以下以”为博客系统添加评论功能”为例,演示从初始化到交付的完整流程。
Step 1: 初始化项目
/gsd:new-project系统会开始持续提问:
> 你想构建什么?"我想为我的 Next.js 博客添加评论功能。支持匿名和登录评论、 Markdown 渲染、管理后台。技术栈用 Prisma + PostgreSQL。"提供的描述越详细,系统追问越少。TÂCHES 的建议是:准备一份粗略的愿景文档,描述你想要什么——不需要知道技术细节。
系统完成后会产出四个文件,并要求你审批路线图。审批后进入构建阶段。
已有代码库? 先运行
/gsd:map-codebase,系统会分析你的现有架构和约定,之后new-project就能基于已有代码进行规划。
Step 2: 讨论阶段
/gsd:discuss-phase 1系统会识别灰色地带并逐一提问:
> 评论嵌套层级:支持多级嵌套还是只支持一级回复?> 匿名评论:需要验证码还是直接提交?> 管理后台:需要批量操作还是逐条审核?你在这里的每个决定都直接影响后续规划质量。如果不确定,可以让系统用默认值——但深入讨论能显著减少执行阶段的返工。
Step 3: 计划阶段
/gsd:plan-phase 1系统会:
- 研究如何用 Prisma + PostgreSQL 实现评论系统
- 创建 2-3 个原子任务计划(如:数据模型、API 路由、前端组件)
- 自动验证计划是否覆盖所有需求
每个计划都足够小,能在一个全新的上下文窗口中完成。
Step 4: 执行阶段
/gsd:execute-phase 1系统开始波次执行:
- Wave 1(无依赖):数据库 schema、Prisma 模型——并行执行
- Wave 2(依赖 Wave 1):API 路由、评论 CRUD——并行执行
- Wave 3(依赖 Wave 2):前端评论组件——独立执行
每个任务在全新的 200k tokens 上下文中执行,完成后独立 git commit。
Step 5: 验证阶段
/gsd:verify-work 1系统引导你逐一确认:
> ✅ 数据库表已创建> ✅ API 路由返回正确状态码> ❓ 能在博客文章下方看到评论输入框吗? [是/否/描述问题]> ❓ 提交评论后页面是否实时更新? [是/否/描述问题]如果有失败项,系统会自动诊断并创建修复计划,再次运行 /gsd:execute-phase 1 即可执行修复。
常见操作场景
插入紧急阶段:需求变更,需要在当前阶段之前插入新工作。
/gsd:insert-phase 2后续阶段自动重新编号(原来的 Phase 2 变成 Phase 3,依此类推)。
暂停与恢复:需要中断工作去处理其他事情。
/gsd:pause-work # 保存当前状态# ... 处理其他事情 .../gsd:resume-work # 恢复到上次中断的位置回滚不满意的结果:
git reset --hard HEAD~3 # 回到执行前的状态/gsd:remove-phase 2 # 级联删除该阶段的所有产出文件TÂCHES 在直播中多次演示这个操作——不喜欢就回滚,干脆利落。
调试工作流
当验证发现问题,或者你在开发过程中遇到 bug 时,GSD 提供了专用调试流程。
/gsd:debug 评论提交后页面没有实时更新系统会启动一个隔离的调试子代理,它的工作流程是:
- 假设 — 基于问题描述生成多个可能的根因假设
- 取证 — 逐一验证假设,检查代码、日志、网络请求
- 解决 — 定位根因后创建修复方案
关键特性:
- 上下文隔离:调试代理有自己的上下文窗口,不会污染主开发上下文
- 文档追踪:创建独立的调试文档记录整个调查过程
- 修复计划:诊断完成后产出可直接执行的修复计划
这比直接在主上下文中调试要高效得多——调试信息不会累积在你的主窗口中。
实战经验
综合 TÂCHES 的直播和 Chase AI 的使用体验,以下是一些实战建议。
放慢才能加快
TÂCHES 坦言自己早期使用 GSD 时也是”快快快”的心态,但后来发现在研究和讨论阶段多花时间,执行阶段的返工反而更少。新版 GSD 增加了 research-project 和 define-requirements 步骤,就是为了在动手前把方向搞对。
“I was definitely when I first started doing things with GSD, I was very much like move fast, move fast, move fast. But I’m just finding that taking these extra steps… I think you’re going to really really love to see the results.”
—— TÂCHES
阶段之间清上下文
TÂCHES 的习惯是每个阶段之间运行 clear,保持主上下文精简。他使用 Warp 终端,每个窗口全屏(Command+Shift+Enter),在一个窗口执行当前阶段的同时,在另一个窗口研究下一个阶段。
Token 成本的权衡
GSD 的子代理方式确实比直接使用 Claude Code 消耗更多 token。但 Chase AI 提出了一个有力的论点:“plan twice, prompt once”(计划两次,提示一次)比”提示一次,然后修修补补”长远来看更省 token。 因为在新鲜上下文中做对一次,比在退化上下文中反复修复要高效得多。
不如意时的处理
如果你对某个阶段的结果不满意,可以 git reset --hard 然后用 /gsd:remove-phase 级联删除该阶段的所有产出文件。TÂCHES 在直播中实际演示了这个操作——他不喜欢某个视觉效果,直接回滚到上一个满意的状态,干脆利落。
To-Do 系统
/gsd:add-todo 可以随时记录想法到待办列表,而不需要修改路线图。这些想法可以在 /gsd:discuss-milestone 时被拉出来,作为下一个里程碑的输入。TÂCHES 的策略是”先做功能,milestone 2 再打磨 UI”。
常见问题与最佳实践
最佳实践
提供详细的初始描述。/gsd:new-project 的质量取决于你的输入质量。准备一份粗略的愿景文档——描述目标、用户、核心功能、已知约束。描述越精确,系统追问越少,规划越准。
阶段之间清理上下文。每完成一个阶段,运行 clear 或 /compact 保持主上下文窗口精简。TÂCHES 的习惯是保持主上下文在 30-40%。
先用 Quick Mode 测试。对于不确定的小功能,先用 /gsd:quick 试水。如果效果好,再在正式路线图中纳入。
对已有项目先 map-codebase。在已有代码库上使用 GSD 前,先运行 /gsd:map-codebase。系统会分析技术栈、架构和约定,之后的规划会更贴合现有代码。
FAQ
Q: GSD 支持哪些运行时?
A: Claude Code、OpenCode 和 Gemini CLI。安装时可以选择单个或全部。
Q: Quick Mode 和完整模式有什么区别?
A: Quick Mode 提供 GSD 的基础保障(原子提交、状态跟踪),但跳过研究、计划检查和验证步骤。适合 bug 修复、小功能、配置变更等不需要完整规划的任务。
Q: 执行过程中可以暂停吗?
A: 可以。/gsd:pause-work 会将当前状态保存到 STATE.md。下次 /gsd:resume-work 时,系统会从上次中断的位置继续。
Q: 如何控制 token 成本?
A: 三种方式——(1) 切换到 budget 配置:/gsd:set-profile budget;(2) 关闭 research 或 plan_check 代理;(3) 对简单任务使用 /gsd:quick。
Q: GSD 可以和 Ralph 一起用吗?
A: 可以。GSD 和 Ralph 解决不同的问题——GSD 负责规划和结构化执行,Ralph 负责自主循环执行。你可以用 GSD 的 new-project 和 plan-phase 生成完整规划,然后用 Ralph 循环来执行那些不需要人类介入的阶段。
Q: 多人协作怎么办?
A: .planning/ 目录可以提交到 Git。多人可以各自运行不同阶段,通过 Git 合并结果。但建议避免同时运行同一阶段。
小结
GSD 的核心价值在于把复杂性藏在系统里,把简单性留给用户。你只需要几个命令——new-project、discuss-phase、plan-phase、execute-phase、verify-work——系统在背后处理所有的上下文管理、子代理编排和质量验证。
从安装到交付,GSD 提供了一条清晰的路径:描述你想要什么 → 讨论实现细节 → 生成原子计划 → 并行执行 → 验证交付物。每一步都有你介入的机会,每一步都有文件记录。
这不是”按一个按钮就搞定”的魔法。这是一个需要你参与但帮你承担大部分认知负担的系统。正如 TÂCHES 所说:你是高层项目经理,GSD 是你的执行团队。