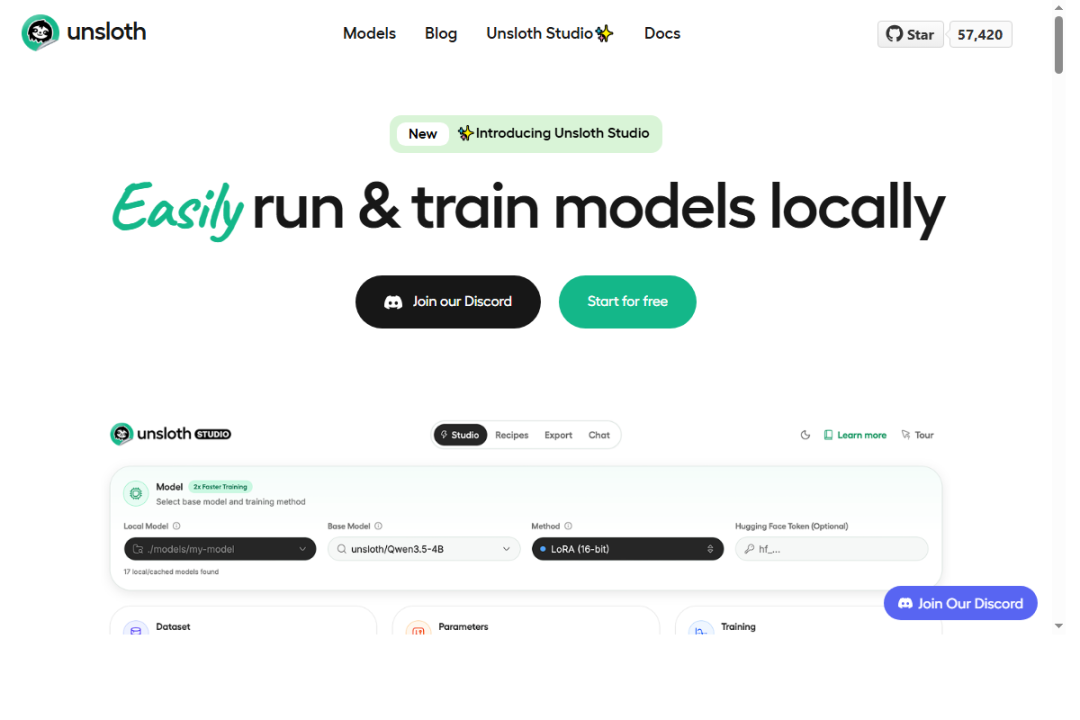
Unsloth Studio横空出世!本地大模型推理+微调,一个界面搞定,速度提升2倍,显存省70%!
本地跑大模型这事,工具链一直是割裂的。 你要跑推理,用LM Studio。界面漂亮,下载模型一键跑, GGUF 生态成熟。但它只能跑,不能训练。 你要微调,开Colab笔记本。写Python,配环境,调参数。训练完了导出模型,再倒回LM Studio去跑。 两套工具,两个环境,...
本地跑大模型这事,工具链一直是割裂的。 你要跑推理,用LM Studio。界面漂亮,下载模型一键跑, GGUF 生态成熟。但它只能跑,不能训练。 你要微调,开Colab笔记本。写Python,配环境,调参数。训练完了导出模型,再倒回LM Studio去跑。 两套工具,两个环境,...
前言 ✍ 在大模型后训练这条线里,大模型的参数量往往是几十亿、上百亿。SFT / RLHF / DPO / GRPO 这些“训练流程”本身固然重要,但如果用 全参数微调(Full Fine-tuning) 去做,显存和存储压力会非常大:为了能够减少训练参数,...
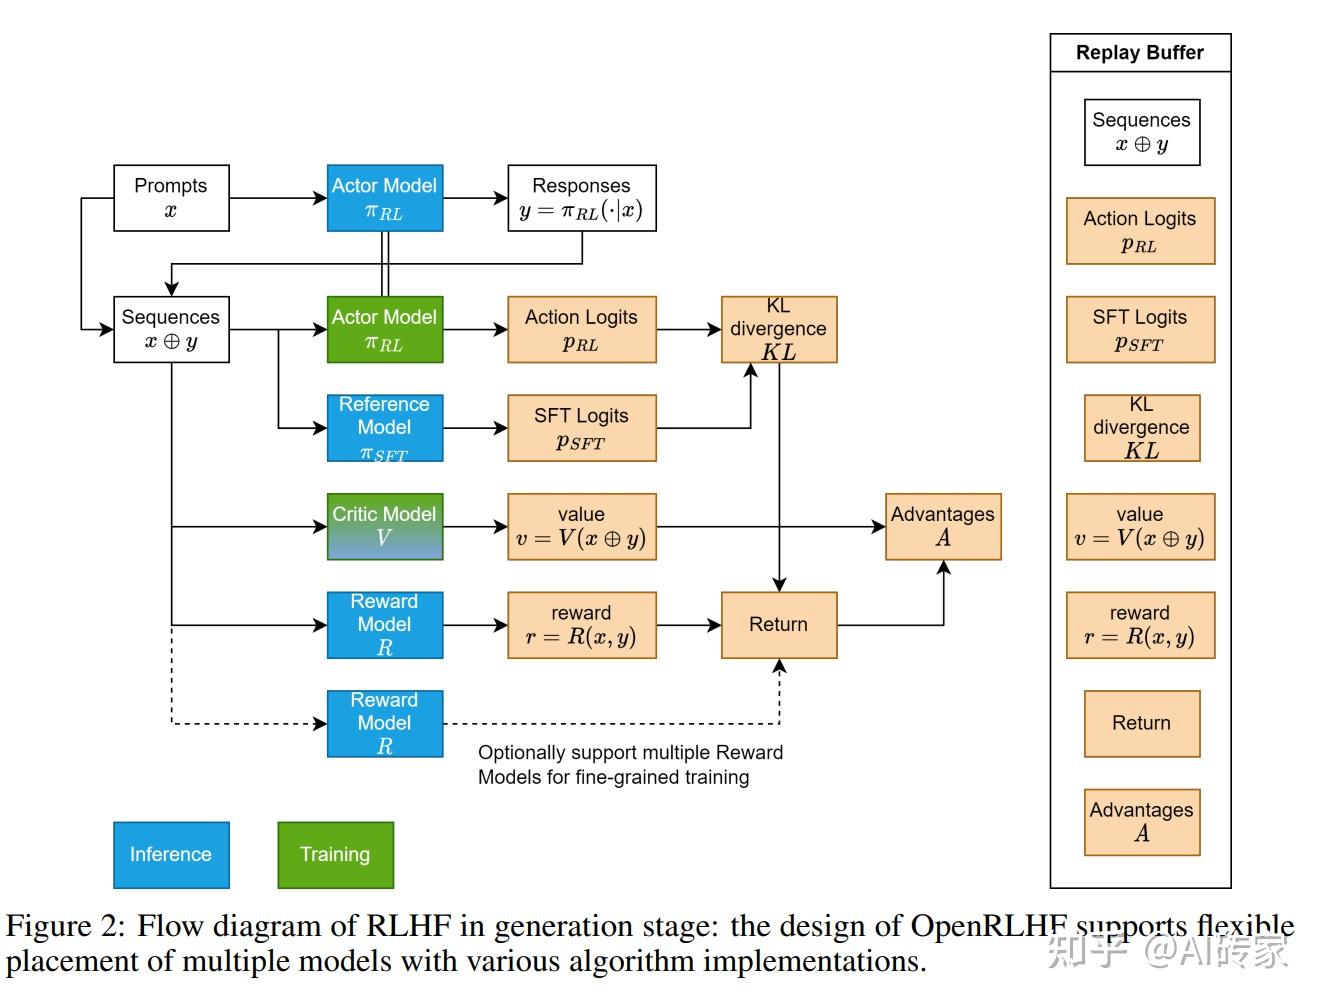
论文: https://arxiv.org/pdf/2405.11143v4 代码: https://github.com/OpenRLHF/OpenRLHF 这个仓库实现了各种RLHF算法,能够快速上手微调自己打LLM或多模态大模型,甚至支持MoE模型;...
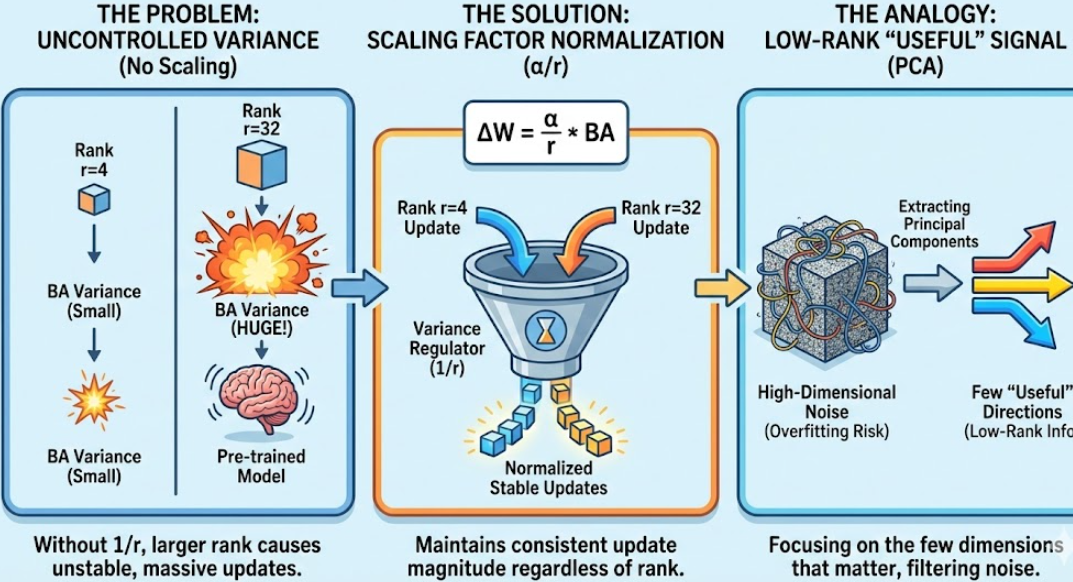
前面QLoRA主要在讲“怎么在全精度模型上优雅地加一个低秩增量 ΔW”。工业界真实场景里依然存在着两个很常见的问题: 显存实在不够,8B / 14B 模型都快撑不住了,LoRA微调依然爆显存,如何进一步解决? LoRA 只是往权重上“加一个低秩偏移”,...
简介: 本文通俗解析大模型微调核心方法:全量微调(效果好但显存昂贵、易遗忘)、LoRA(冻结原权重,低秩矩阵高效适配,适合注入领域知识)、P-Tuning(学习软提示,擅长安排风格与指令)。厘清术语差异,给出实战选型建议与关键参数调优要点,助开发者跨越入门门槛。...
前言 QLoRA[1]的作者Tim Dettmers是一个在模型量化颇有建树的大佬,而且参加了谷歌的BLOOM的工程化建设。模型量化和大模型的PEFT(Parameter-Efficient Fine-Tuning)有一个共同点是它们都希望模型计算能够更快。...
数字时代,人工智能AI和机器学习技术的快速发展,人们的生活和工作模式正在经历一场前所未有的变革,CPU、GPU、TPU、NPU等作为科技领域重要组件,都可看作是机器的大脑,在各自领域发挥着重要作用,各有千秋。...
操作系统是Ubuntu 22.04.5,搭配Nvidia 8G的显卡,用户是ubuntu,尽量用普通用户操作 先上去看: nvidia-smi root@ollama:~# nvidia-smi Command 'nvidia-smi' not found,...
在 AI 炼丹界有一句至理名言:“数据决定上限,模型只是逼近这个上限。” Unsloth “硬目标”蒸馏步骤 这种方法在工业界极其流行:用顶级大模型(GPT-4 或 Qwen-72B)生成海量高质量语料,然后用 Unsloth 对小模型(Qwen-0....
快速阅读:Sebastian Raschka整理了从2024年初到2026年春天发布的40多个开源大模型的架构图谱。这些模型几乎都在做同一件事:想办法让注意力机制便宜一点、快一点、跑得更长,同时保住性能。收敛的是设计语言(MoE、QK-Norm、滑窗注意力成了标配),...