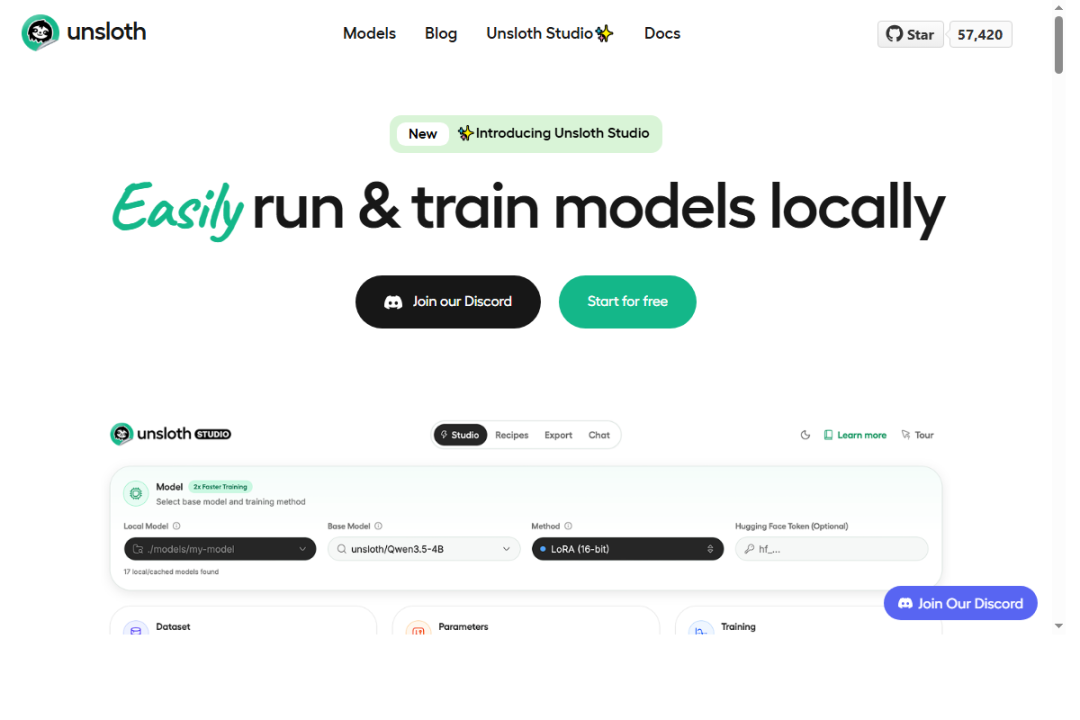
Unsloth Studio横空出世!本地大模型推理+微调,一个界面搞定,速度提升2倍,显存省70%!
本地跑大模型这事,工具链一直是割裂的。 你要跑推理,用LM Studio。界面漂亮,下载模型一键跑, GGUF 生态成熟。但它只能跑,不能训练。 你要微调,开Colab笔记本。写Python,配环境,调参数。训练完了导出模型,再倒回LM Studio去跑。 两套工具,两个环境,...
本地跑大模型这事,工具链一直是割裂的。 你要跑推理,用LM Studio。界面漂亮,下载模型一键跑, GGUF 生态成熟。但它只能跑,不能训练。 你要微调,开Colab笔记本。写Python,配环境,调参数。训练完了导出模型,再倒回LM Studio去跑。 两套工具,两个环境,...
前面QLoRA主要在讲“怎么在全精度模型上优雅地加一个低秩增量 ΔW”。工业界真实场景里依然存在着两个很常见的问题: 显存实在不够,8B / 14B 模型都快撑不住了,LoRA微调依然爆显存,如何进一步解决? LoRA 只是往权重上“加一个低秩偏移”,...
操作系统是Ubuntu 22.04.5,搭配Nvidia 8G的显卡,用户是ubuntu,尽量用普通用户操作 先上去看: nvidia-smi root@ollama:~# nvidia-smi Command 'nvidia-smi' not found,...
在 AI 炼丹界有一句至理名言:“数据决定上限,模型只是逼近这个上限。” Unsloth “硬目标”蒸馏步骤 这种方法在工业界极其流行:用顶级大模型(GPT-4 或 Qwen-72B)生成海量高质量语料,然后用 Unsloth 对小模型(Qwen-0....

