模型在”标准化考试”上已经快摸到顶了,但在”真实任务执行”上才刚刚起步。 HCI 的用意并非给模型排座次,而是作为一张诊断图,指明哪些领域的”剩余空间”最丰厚——这正是 RSI 未来最应该发力去啃的硬骨头。
自OpenAI 组建RSI 团队,Anthropic 发布《When AI Builds Itself》,Google DeepMind 用 AlphaEvolve 优化自家芯片。
RSI(Recursive Self-Improvement,递归式自我改进)很快进入了大众视野。
国内也接着出了一份RSI行业分析报告,详细的阐述RSI该如何落地。发布仅 10 小时就达到百万浏览。
 图片
 图片
Theseus Labs通过收集OpenAI、Anthropic、Google DeepMind、Meta、腾讯混元、字节 Seed 等 72 家公司与团队的公开材料,用”改进循环”作为分析单元,系统梳理了 RSI 的技术路线、产业实践和评估挑战,最终给出从 L1 到 L5 的自主权路线图。

用一把尺子HCI,量出模型的”能力余量”
要判断模型离真正的自主还有多远,首先得有一把统一的尺子。Theseus Labs 构建了一个新指标——HCI(Headroom-Closed Index,能力余量闭合指数)。
HCI 衡量的是:相较于某项评测最初的前沿水平,模型填补了多少通往满分的差距。计算方式很直观:
HCI =(当前得分 − 基准得分)÷(100 − 基准得分)× 100
例如某评测基准年得分 60 分、当前得分 80 分,HCI 就是 50,意味着原有提升空间已被填补一半。汇总某个领域时,先取各评测每年 HCI 的第 90 百分位代表当年前沿水平,再按参与模型数量的平方根加权平均——既兼顾覆盖度,又避免规模最大的评测主导结果。
他们汇集了 2023 年至 2026 年间、覆盖 10 大能力领域的 393 组模型与基准测试观测。
到今年为止,前沿数学的 HCI 已达 86.4,研究生级科学为 85.8,广博知识为 77.2;然而法律推理只有 64.5,多模态推理 62.2,前沿学术广度 60.4。
说得直白一点:模型在”标准化考试”上已经快摸到顶了,但在”真实任务执行”上才刚刚起步。 HCI 的用意并非给模型排座次,而是作为一张诊断图,指明哪些领域的”剩余空间”最丰厚——这正是 RSI 未来最应该发力去啃的硬骨头。
五级自主权:从”执行”到”递归继承”
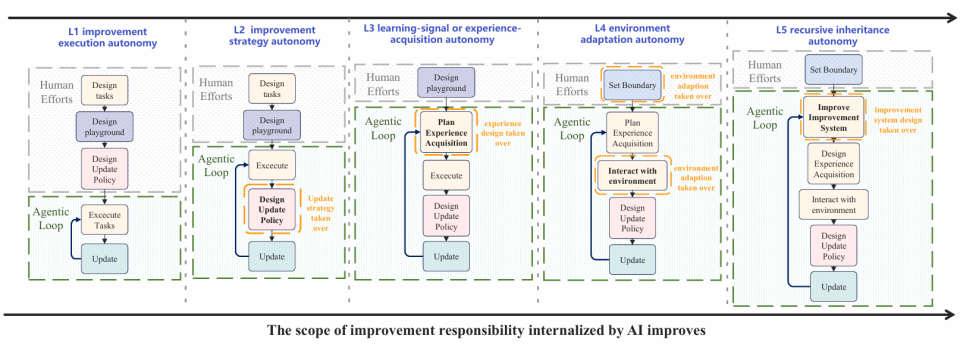
基于 HCI 的诊断,Theseus Labs 按 AI 在改进循环中承担的责任,发布了 RSI 五级框架,首次系统定义了”递归自我改进”的阶梯。
 图片
- L1 执行自主:人类设计任务、设计试验环境、设计更新策略;智能体闭环只负责执行任务、更新。
- L2 策略自主:人类设计任务、设计试验环境;智能体闭环增加”设计更新策略”,策略由系统持久化沉淀。
- L3 经验获取自主:人类只负责设计试验环境;智能体自主规划经验获取、执行、设计更新策略,经验设计由系统持久化沉淀。
- L4 环境适应自主:人类只设定边界;智能体自主规划经验获取、与环境交互、设计更新策略,环境适应由系统持久化沉淀。
- L5 递归继承自主:人类依然只设定边界;智能体则开始”改进改进系统本身”——设计经验获取、与环境交互、设计更新策略,改进系统设计本身也被持久化沉淀。
每个层级里,人类投入的部分在逐步退出,智能体闭环接管的部分在逐步扩张。
用一个直观的类比:把能力提升比作登山,L4 是在既定路线上适应环境完成目标;
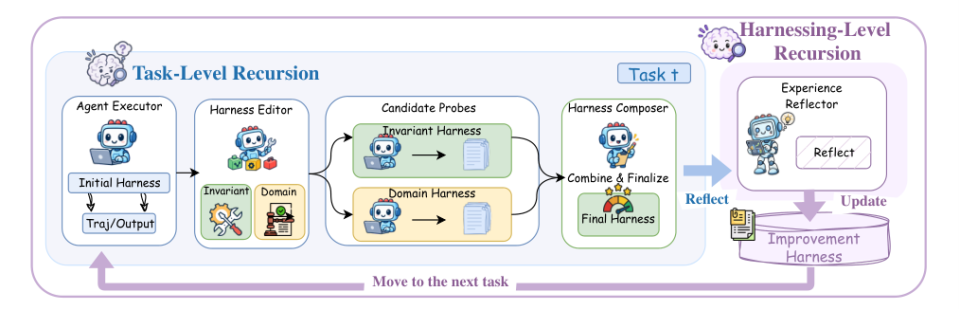
而 L5 会关注”登山方法”本身——自主发现能力前沿、思考受阻原因、选择更值得尝试的路线,并把验证过的新方法传给下一代继续使用和改进。
 图片
到了 L5 这一级,每轮进步不仅让 AI 更能干,还能让下一轮改进更高效、更可靠——但这种持续递归的收益,目前仍缺乏充分验证。
这也正是”递归继承”名称的含义:决定后续改进的机制本身,开始由 AI 接管。
4.大厂进度,绝大多数还停在 L1–L2
沿着五级阶梯看,全球头部玩家的路线选择已经明显分化:有人从模型权重和训练规则切入,有人从 Harness、记忆和技能库入手,还有人把赌注押在评估器与奖励机制的持续演化上。
目前大厂主要集中在 L1–L2:
- OpenAI Symphony、Anthropic Agent Skills 为任务衔接与技能复用提供支撑,减少重复操作;
- OpenAI GPT-Red 的攻防自博弈、Anthropic Claude 的工具优化,以及微软 Agent Lightning、DeepSeek R1,把策略改进纳入自动化闭环——让人工逐项调试转向批量试验与反馈驱动的优化。
向 L3 迈进的有腾讯 R-Zero,它开始自主出题、求解,减少对人工准备学习任务的依赖。
到了 L4,Factory Signals 以及作为候选的 OpenAI 自改进税务智能体,着力把部署中的失败转成后续更新,缩短”发现问题—修复—验证”的链路。
至于 L5,Meta HyperAgents、Sakana Darwin Gödel Machine、Weco AIDE2 尚属候选,Anthropic 的《When AI Builds Itself》仍是目标愿景。
 图片
关键区别在于:L1–L4 主要是在既定改进机制下提升任务能力,而 L5 的”决定后续改进的机制”,才可能触及有效递归。
真正的提升,必须在同等预算下通过独立评估来确认,不能仅靠自我修改或自评分来宣称进步。
总体目标与安全边界,始终由人类把关。
5.模型的短板,恰恰是 RSI 的破局点
在 HCI 的观测中,最让人警醒的是”交互类能力”的严重滞后。
以 2026 年数据为证:软件工程 HCI 仅为 52.6,搜索与终端 Agent 为 56.8,而工具调用 Agent 更是低至 39.9——相比之下,研究生级科学高达 85.8,两者相差 33 到 46 分。
更值得注意的是:工具 Agent 的得分在年内实现了从 8.2 到 39.9 的猛涨,但仍处于全场最低位;而同步领先的网络安全 Agent 已触达 91.9 的高度,两者相差 52 分之多。
这说明,”边界清晰、容易验证”的环境里取得的测试增益,并不能自动迁移到”长程/有状态”的真实工作流中。
简单测评主要锻炼 L1–L2 的能力,环境类任务对应 L2–L3,而只有长程交互工作流,才能真正暴露出系统在 L3–L4 阶段所需的验证、记忆、适应能力。
那么 RSI 究竟能带来多大的增量?Theseus Labs 给出了一个示意性的延伸公式:
R = 100 − 0.22 ×(100 − 2026 年 HCI)
即假设 RSI 能按目前 0.22 的系数填补缺口,各领域的理论上限能摸到哪里。
测算结果相当可观:网络安全可从 91.9 提升至 98.2,软件工程可从 52.6 跃升至 89.6,搜索与终端从 56.8 提升至 90.5,工具 Agent 更是能从 39.9 直接拉高到 86.8。
为什么 RSI 能补上这个缺口?
因为”干活”需要长程交互、反复试错、回归测试,这正是 RSI 在积累经验与验证更新上的强项。
换句话说:现有能力缺口越大的领域,能从 RSI 中获得的潜在提升红利就越高。
 图片
反复生成经验、验证更新、做回归测试,最能帮助那些”部署工作流薄弱”的环节,这是工程上最容易切入和落地的入口。
软件工程和工具使用型 Agent 距离能力天花板最远,RSI 的杠杆效应也最强。
工业实践,产业界已经跑起来了
RSI 不是纯理论。在工业实践部分,Theseus Labs 梳理了 Theseus、Lark、Humanlaya、ModelBest、腾讯混元、Agent-Native Research Lab 等系统的初步探索,每一个都交出了实打实的数字:
 图片
Humanlaya(交付驱动的数据质量保障):经过四轮反馈驱动更新,关键缺陷率从 **9.0% 降至 3.7%**,平均人工处理时间从 48 分钟降至 27 分钟。
 图片
面壁智能(ModelBest)(零人工工业 AI 工程):让 Agent 自主完成工程设计、实现和优化,并沉淀经验复用,其 ForgeStencil 实现了 1.15–1.9× 加速。
 图片
腾讯混元(经验驱动的自改进):把代码、日志和评估反馈沉淀为经验,驱动下一轮实验;在 nanochat 上验证 BPB 从 0.9109 降至 0.9015。
 图片
此外,小红书生成式推荐利用推荐后的真实反馈持续校正用户记忆,并将高价值难例转化为后训练样本,形成”记忆更新+模型迭代”的双层闭环;
阶段性实验中,Feed 的精排分 score_mean@16 从 2.211 提升至 2.366,提升约 **7.0%**。
Lark 则构建企业级 RSI 的数据底座,把协同数据持续结构化、评估并提炼为高质量知识与训练信号。
四个领域,不同的速度
除了厂商实践,Theseus Labs 还比较了 4 个实际应用领域,明确指出不同的领域正以不同速度向 RSI 迈进。
软件工程进展最远,而科学、机器人技术和医疗保健则更为受限——因为这些领域的反馈更难获得、或更冒险地验证。
“反馈成本””可验证性””部署约束”这三点,共同决定了 RSI 在每个领域的进展速度。
这也解释了为什么软件工程和工具使用型 Agent 会成为各家发力的第一站:工程任务的反馈廉价、验证明确、部署链路短,天然是 RSI 循环最容易闭合的土壤。
一次成功之后,还要问四个问题
报告在 L5 评估中特别强调:真正的递归改进,不能只看一次成功,还要追问四个问题——
- 可衡量:改进是否真实?能否在独立评估下复现?
- 可保持:改进能否持久保留,而不退化?
- 可迁移:改进能否跨任务、跨领域复用?
- 可回滚:改进失效时,能否安全撤回?
这四问,决定了 RSI 究竟是”一次性刷榜”,还是可持续的改进能力。
Theseus 自己的解法:环境—数据—模型协同进化
作为提出这份路线图的实验室,Theseus Labs 也有自己的落地解法,而且非常直观:先重构环境,再借环境发现真实能力缺口、生成训练数据,随后训练任务模型,最后用更强的模型推动下一轮环境迭代。
具体拆成四步:
- 重构环境:学习怎样把原始工作区还原成可供 Agent 训练与评估的环境;
- 暴露缺口:借助新环境发现真实能力缺口,并生成训练数据;
- 再训练模型:用生成的数据训练任务模型;
- 迭代环境:用更强模型推动下一轮环境迭代,形成闭环。
写在最后
报告标题里”Last AI Built by Humans”(人类建造的最后一个 AI),其实是一种提醒,每一次被验证的改进,都是下一轮探索的起点,智能增长形成杠杆,有限的资源撬动持续的跃迁。
这是Theseus Labs 给出的路线图,RSI 还很早,但通往”完全体”的路,已经第一次被清晰地画了出来。
https://arxiv.org/abs/2609.11873
责任编辑:武晓燕来源: CourseAI